<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://ulti-dreisteine.github.io/academicpages/feed.xml" rel="self" type="application/atom+xml" /><link href="https://ulti-dreisteine.github.io/academicpages/" rel="alternate" type="text/html" /><updated>2026-07-01T11:28:50+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/feed.xml</id><title type="html"> </title><subtitle>罗磊的学术主页</subtitle><author><name>罗磊</name><email>dreisteine262@163.com</email></author><entry><title type="html">Box-Jenkins模型辨识</title><link href="https://ulti-dreisteine.github.io/academicpages/Box-Jenkins%E6%A8%A1%E5%9E%8B%E8%BE%A8%E8%AF%86/" rel="alternate" type="text/html" title="Box-Jenkins模型辨识" /><published>2026-05-25T00:00:00+00:00</published><updated>2026-05-25T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/Box-Jenkins%E6%A8%A1%E5%9E%8B%E8%BE%A8%E8%AF%86</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/Box-Jenkins%E6%A8%A1%E5%9E%8B%E8%BE%A8%E8%AF%86/"><![CDATA[<p>辨识的目的是从动态数据中识别输入对输出的<strong>真实</strong>影响。这里的真实，指的是<strong>不受测量误差、未建模动态、环境漂移等因素干扰</strong>的影响。接下来，我将通过Box-Jenkins（BJ）模型辨识来阐述这一观点。</p>

<h2 id="一基本介绍"><strong>一、基本介绍</strong></h2>

<p>BJ模型的形式为：</p>

\[\begin{align*}
y_k &amp;= G(z)u_k + H(z)e_k \\
    &amp;= \frac{B(z)}{F(z)}u_k + \frac{C(z)}{D(z)}e_k, \\
\end{align*}\]

<p>其中，噪声通道 $H(z) = C(z)/D(z)$ 描述了系统的噪声特性，负责<strong>吸收所有与输入 $u_k$ 无关的波动</strong>（测量误差、未建模动态、环境漂移等）。</p>

<p>由于系统假设“物理过程的惯性”和“环境干扰的扩散规律”相互独立，因此BJ模型可以实现比ARMAX等模型更好的信噪分离效果。但是，<strong>有色噪声 $H(z)e_k$ 的存在导致我们无法直接使用常规的线性最小二乘法（OLS）求出解析解</strong>，必须通过非线性优化迭代算法（如 Gauss-Newton 或 Levenberg-Marquardt）来求解参数。</p>

<hr />
<h2 id="二参数估计"><strong>二、参数估计</strong></h2>

<p>采用预测误差法（Prediction Error Method, PEM）对BJ模型进行参数估计。首先，分离出当前时刻的白噪声项：</p>

\[e_k = \frac{D(z)}{C(z)}\left[y_k - \frac{B(z)}{F(z)}u_k\right]\]

<p>注意，$y_k$ 表示当前时刻输出观测值，$u_k$ 是当前时刻输入值。上式表示，如果我们知道了 $B(z)$、$F(z)$、$C(z)$ 和 $D(z)$ 的参数，以及当前时刻的输入和输出观测数据，就可以计算出当前时刻的预测误差 $e_k$，进而知道当前时刻输出的估计值：</p>

\[\begin{align*}
\hat{y}_k &amp;= y_k - e_k \\
&amp;= y_k - \frac{D(z)}{C(z)}\left[y_k - \frac{B(z)}{F(z)}u_k\right] \\
&amp;= \left[1 - \frac{D(z)}{C(z)}\right]y_k + \frac{D(z)}{C(z)}\frac{B(z)}{F(z)}u_k \\
\end{align*}\]

<p>这里的 $\hat y_k$ 是排除了噪声影响后的输出估计值，是 $u_k$ 对 $y_k$ 的<strong>真实</strong>影响。</p>

<p>PEM 的目标就是通过最小化所有时刻的预测误差平方和来求解参数：</p>

\[\begin{aligned}
\hat{\theta} &amp;= \underset{\theta}{\mathrm{argmin}} \sum_{k=1}^{N} e_k^2 \\
    &amp;= \underset{\theta}{\mathrm{argmin}} \sum_{k=1}^{N} \left[y_k - \hat{y}_k\right]^2 \\
    &amp;= \underset{\theta}{\mathrm{argmin}} \sum_{k=1}^{N} \left(\frac{D(z)}{C(z)}\left[y_k - \frac{B(z)}{F(z)}u_k\right]\right)^2 \\
\end{aligned}\]

<p>对应的损失函数为：</p>

\[J(\theta) = \sum_{k=1}^{N} e_k^2 = \sum_{k=1}^{N} \left[y_k - \hat{y}_k\right]^2.\]

<p>当 $J(\theta)$ 收敛到局部最小值时，留下来的残差将退化为完美的白噪声。这代表数据中的所有有用信息（物理规律、时序相关性）已被 BJ 模型完全榨干，实现<strong>信噪分离</strong>，从而得到了输入对输出的<strong>真实</strong>影响。</p>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[辨识的目的是从动态数据中识别输入对输出的真实影响。这里的真实，指的是不受测量误差、未建模动态、环境漂移等因素干扰的影响。接下来，我将通过Box-Jenkins（BJ）模型辨识来阐述这一观点。]]></summary></entry><entry><title type="html">Fisher信息量与系统辨识</title><link href="https://ulti-dreisteine.github.io/academicpages/Fisher%E4%BF%A1%E6%81%AF%E9%87%8F%E4%B8%8E%E7%B3%BB%E7%BB%9F%E8%BE%A8%E8%AF%86/" rel="alternate" type="text/html" title="Fisher信息量与系统辨识" /><published>2026-05-25T00:00:00+00:00</published><updated>2026-05-25T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/Fisher%E4%BF%A1%E6%81%AF%E9%87%8F%E4%B8%8E%E7%B3%BB%E7%BB%9F%E8%BE%A8%E8%AF%86</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/Fisher%E4%BF%A1%E6%81%AF%E9%87%8F%E4%B8%8E%E7%B3%BB%E7%BB%9F%E8%BE%A8%E8%AF%86/"><![CDATA[<p>若随机变量 $X$ 的分布依赖于参数 $\theta$，则Fisher信息是用于度量 $X$ 所携带的关于参数 $\theta$ 的信息量。</p>

<hr />

<h2 id="一最大似然估计">一、最大似然估计</h2>

<p>设随机变量 $X$ 的概率依赖于参数 $\theta$，概率密度函数为：</p>

\[p(X;\theta) \tag{1}\]

<table>
  <tbody>
    <tr>
      <td>如果采集得到了 $X$ 的一系列样本 ${x_i</td>
      <td>i=1,2,\cdots,N}$，采用最大似然估计（maximum likelihood estimation, MLE）对 $\theta$ 进行估计时，定义的似然函数为：</td>
    </tr>
  </tbody>
</table>

\[L(\theta) = \prod_{i=1}^{N}p(x_i;\theta) \tag{2}\]

<p>两边取自然对数有：</p>

\[l(\theta)=\ln L(\theta) = \sum_{i=1}^n \ln p(x_i;\theta) \tag{3}\]

<p>取使得 $l(\theta)$ 最大的 $\theta$ 作为参数估计结果 $\hat\theta_{MLE}$，此时有</p>

\[\frac{\partial l(\theta)}{\partial \theta}\Big|_{\theta ={\hat\theta_{MLE}}} =0 \tag{4}\]

<p>式（3）左侧似然函数关于参数的偏导数被称为<mark>评估分数</mark>（score）。</p>

<hr />

<h2 id="二fisher信息量">二、Fisher信息量</h2>

<p>如果 $\theta^<em>$ 就是 $X$ 分布密度 $p(X;\theta)$ 的<strong>真实参数</strong>，则在 $\theta^</em>$ 处式（3）评估分数的期望为0：</p>

\[\mathbb E_{X}\left[
\frac{\partial l(\theta)}{\partial \theta}\Big|{\theta=\theta^*}
\right] = 0 \tag{5}\]

<p>而Fisher信息则为评估分数对应的方差：</p>

\[{\cal I}(\theta^*) = {\mathbb E}_{X}\left[
\left(\frac{\partial l(\theta)}{\partial \theta} \right)^2 \Big|{\theta=\theta^*}
\right] \tag{6}\]

<p>容易看出</p>

\[{\cal I}(\theta^*) \geq 0 \tag{7}\]

<p>如果 $l(\theta)$ 关于 $\theta$ 是<strong>二次可微</strong>的，则可证明：</p>

\[{\cal I}(\theta^*) = -{\mathbb E}_{X}\left[
\frac{\partial^2 l(\theta)}{\partial \theta^2} \Big|{\theta=\theta^*}
\right] \tag{8}\]

<p>对Fisher信息的直观理解：</p>

<ol>
  <li>
    <p>如果参数 $\theta^<em>$ 的Fisher信息量越大，则根据式（8）中的二阶导数形式，似然函数 $l(\theta)$ 在 $\theta^</em>$ 处的变化斜率绝对值就越大，这样一来，待估计参数 $\theta$ 值的小幅变化都会导致似然函数 $l(\theta)$ 的显著改变，那么我们就更容易准确估计 $\theta^*$ 的取值，这就表明 $X$ 携带了关于确定 $\theta$ 的更多信息；</p>
  </li>
  <li>
    <p>这意味着我们可以优化 $X$ 采样以提升对参数 $\theta$ 估计的准确性。</p>
  </li>
</ol>

<hr />

<h2 id="三fisher信息用于系统辨识">三、Fisher信息用于系统辨识</h2>

<p>在系统辨识中，通常采用<strong>Fisher信息矩阵</strong>逆的标量函数指导最优输入信号条件的构造，从而进行参数估计。如果指标函数为</p>

\[J = \phi({\mathbf M}^{-1}) \tag{9}\]

<table>
  <tbody>
    <tr>
      <td>其中 $\mathbf M$ 为Fisher信息矩阵。如果系统输入输出样本集为 $S = {(u_i, x_i)</td>
      <td>i=1,2,\cdots,N}$,带估计参数为 $\theta = {\theta_1,\theta_2,\cdots,\theta_M}$，则根据式（6）有</td>
    </tr>
  </tbody>
</table>

\[\mathbf M = {\mathbb E}_S \left[
    \left( \frac{\partial l(\theta|S)}{\partial \theta} \right)
    \left( \frac{\partial l(\theta|S)}{\partial \theta} \right)^T
\right] \tag{10}\]

<p>常用的度量函数 $\phi(\cdot)$ 形式有：</p>

<ol>
  <li>
    <p>A-最优准则：$J = {\rm Tr}({\mathbf{M}}^{-1})$ 或 $J = {\rm Tr}({\mathbf W}{\mathbf M}^{-1})$；</p>
  </li>
  <li>
    <p>D-最优准则：$J = \det({\mathbf M}^{-1})$ 或 $J = \log\left(\det\left({\mathbf M}^{-1}\right)\right)$。</p>
  </li>
</ol>

<p>其中 $\mathbf W$ 为非负定矩阵。</p>

<hr />

<h2 id="四辨识输入信号选择">四、辨识输入信号选择</h2>

<p>通过Fisher信息矩阵可知，当系统为单输入单输出且残差为<strong>独立同分布正态序列</strong>时，通过D-最优准则可获得辨识输入的自相关函数应满足脉冲形式。更一般地，Goodwin和Payne提出：如果<mark>模型结构正确</mark>，且<mark>参数估计值 $\hat\theta$ 是无偏最小方差估计</mark>，则对参数 $\hat\theta$ 的辨识精度将依赖于输入信号 $u$，<mark>**最优辨识输入信号是具有脉冲式自相关函数的信号**</mark>，即</p>

\[\frac{1}{N}\sum_{k=1}^N u_{k-i} u_{k-j} = \left\{
\begin{matrix}
    1, i = j \\
    0, i \neq j \\
\end{matrix}
\right.\]

<p>当样本数 $N$ 很大时，<mark>白噪声或M序列</mark>可近似满足此要求；否则，并非对所有 $N$ 都能找到这种信号。</p>

<p>在<mark>**具体工程应用**</mark>中，辨识输入信号的选择还需考虑：</p>

<ol>
  <li>
    <p><mark>输入信号的功率和幅度不应过大</mark>，避免系统工作区呈现非线性或对运行安全等构成影响；也不应过小导致辨识信噪比过低和辨识精度下降；</p>
  </li>
  <li>
    <p>输入信号对系统的<mark>“净扰动”要小</mark>，即使正负扰动的概率均等；</p>
  </li>
  <li>
    <p>维纳-辛钦关系式：输入信号频谱需宽于系统频谱以<mark>充分激励系统</mark>；</p>
  </li>
</ol>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[若随机变量 $X$ 的分布依赖于参数 $\theta$，则Fisher信息是用于度量 $X$ 所携带的关于参数 $\theta$ 的信息量。]]></summary></entry><entry><title type="html">基于线性回归的CRLB解释</title><link href="https://ulti-dreisteine.github.io/academicpages/%E5%9F%BA%E4%BA%8E%E7%BA%BF%E6%80%A7%E5%9B%9E%E5%BD%92%E7%9A%84CRLB%E8%A7%A3%E9%87%8A/" rel="alternate" type="text/html" title="基于线性回归的CRLB解释" /><published>2026-05-25T00:00:00+00:00</published><updated>2026-05-25T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/%E5%9F%BA%E4%BA%8E%E7%BA%BF%E6%80%A7%E5%9B%9E%E5%BD%92%E7%9A%84CRLB%E8%A7%A3%E9%87%8A</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/%E5%9F%BA%E4%BA%8E%E7%BA%BF%E6%80%A7%E5%9B%9E%E5%BD%92%E7%9A%84CRLB%E8%A7%A3%E9%87%8A/"><![CDATA[<p>克拉美罗下界（Cramér-Rao Lower Bound, CRLB）是系统辨识里的重要概念，用于衡量参数估计的下界精度。</p>

<h2 id="一最大似然估计"><strong>一、最大似然估计</strong></h2>

<p>Fisher信息由频率学派最大似然估计（Maximum Likelihood Estimation, MLE）而来。基于MLE进行参数估计：</p>

\[L(\theta|x_1,x_2,\cdots,x_n) = \prod_{i=1}^{n}f(x_{i}\mid\theta)\]

\[\hat \theta_{\text{MLE}} = \arg\max_{\theta} L(\theta|x_1,x_2,\cdots,x_n)\]

<p>为方便计算，取对数形式，可得：</p>

\[\log L(\theta|x_1,x_2,\cdots,x_n) = \log L(\theta|X) = \sum_{i=1}^{n} \log f(x_{i}\mid\theta) \\
\hat \theta_{\text{MLE}} = \arg\max_{\theta} \log L(\theta|x_1,x_2,\cdots,x_n) = \arg\max_{\theta} \sum_{i=1}^{n} \log f(x_{i}\mid\theta)\]

<p>如果概率密度/质量函数关于$\theta$可导（该前提一般都满足），则MLE估计量满足以下条件：</p>

\[\frac{\partial}{\partial \theta} \log L(\theta|x_1,x_2,\cdots,x_n) = \frac{\partial}{\partial \theta} \log L(\theta|X) = \frac{\partial}{\partial \theta} \ell(\theta|X) = 0\]

<p>对于一般的线性回归模型：</p>

\[Y = X^T \theta + \epsilon\]

<p>如果误差项 $\epsilon$ 服从正态分布，则最小二乘（Ordinary Least Squares, OLS）所得参数估计结果与MLE相同（见最后附录），即：</p>

\[\begin{aligned}
\hat{\theta}_\text{OLS} &amp;= \arg\min_{\theta} \sum_{i=1}^{n} (y_i - f(x_i, \theta))^2 \\
&amp;= \arg\min_{\theta} \|Y - X^T\theta\|^2
\end{aligned}\]

\[\frac{\partial}{\partial \theta} \|Y - X^T\theta\|^2 = -2X^T(Y - X^T\theta) = 0\]

<p>则有：</p>

\[\hat{\theta}_\text{OLS} = (X^TX)^{-1}X^TY\]

<hr />

<h2 id="二fisher信息"><strong>二、Fisher信息</strong></h2>

<table>
  <tbody>
    <tr>
      <td>令 $S(\theta</td>
      <td>X)$ 为得分函数：</td>
    </tr>
  </tbody>
</table>

\[S(\theta|X) = \frac{\partial}{\partial \theta} \ell(\theta|X) = \frac{\partial}{\partial \theta} \log L(\theta|X)\]

<p>对于一组给定的观测样本 $X$，其MLE估计量 $\hat{\theta}_X$ 满足：</p>

\[S(\hat{\theta}_X|X) = 0\]

<p>如果 $\theta^*$ 为真实参数，则其得分函数的期望为零：</p>

\[\mathbb{E}_X[S(\theta^*|X)] = 0\]

<p>而Fisher信息定义为得分函数的方差：</p>

\[I(\theta) = \mathbb{E}_X \left[ \left( \frac{\partial}{\partial \theta} \log L(\theta|X) \right)^2 \right] = \mathbb{E}_X \left[ S(\theta|X)^2 \right]\]

<p>在正则条件下</p>

\[I(\theta) = -\mathbb{E}_X \left[ \frac{\partial^2}{\partial \theta^2} \log L(\theta|X) \right]\]

<p>$I(\theta)$ 越大，表明样本对参数 $\theta$ 估计提供的信息越多，估计方差越小。由此引出Cramér-Rao下界（CRLB）：</p>

<p>任何正则无偏估计量的方差都受到Cramér-Rao下界的限制：</p>

\[\mathrm{Var}(\hat{\theta}) \geq \frac{1}{I(\theta)}\]

<p>而在大样本极限下，MLE的方差趋近于Cramér-Rao下界：</p>

\[\sqrt{n}(\hat{\theta}_\text{MLE} - \theta) \xrightarrow{d} \mathcal{N}\left(0, \frac{1}{I(\theta)}\right)\]

<hr />

<h2 id="三matlab中对crlb的计算"><strong>三、Matlab中对CRLB的计算</strong></h2>

<p>Matlab系统辨识模型一般形式为：</p>

\[y(t) = G(q, \theta)u(t) + H(q, \theta)e(t)\]

<p>其中，$e(t)$ 为方差 $\lambda = \sigma^2$ 的白噪声。</p>

<p>接下来，Matlab采用观测Fisher信息矩阵来计算CRLB：</p>

\[\hat{I}(\hat{\theta}) = - \frac{\partial^2 \ell(\hat{\theta})}{\partial \theta^2}|_{\theta=\hat{\theta}}\]

<p><strong>在Gauss-Newton或Levenberg-Marquardt优化算法中，该二阶导数Hessian矩阵被近似为雅可比矩阵的乘积，从而简化计算。</strong></p>

<p>最后，计算<strong>持续激励大样本量条件下</strong>的CRLB和参数估计的协方差矩阵：</p>

\[\text{Cov}(\hat{\theta}) \sim \hat{I}(\hat{\theta})^{-1}\]

<hr />

<h2 id="四基于线性回归的算例"><strong>四、基于线性回归的算例</strong></h2>

<p>这里使用一个简单的2x2线性回归模型作为算例，以阐述Fisher信息矩阵和CRLB的计算过程。该线性回归的方程为：</p>

\[y = \theta_0 + \theta_1 x + \epsilon, \quad \epsilon \sim \mathcal{N}(0, \Sigma)\]

<p>其中，</p>

\[\begin{aligned}
\theta_0 &amp;= [1, 2]^T \\
\theta_1 &amp;= \begin{bmatrix} 1 &amp; 2 \\ 3 &amp; 4 \end{bmatrix} \\
\Sigma &amp;= \begin{bmatrix} 0.1 &amp; 0 \\ 0 &amp; 0.1 \end{bmatrix}
\end{aligned}\]

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
</code></pre></div></div>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">gen_samples</span><span class="p">(</span><span class="n">N</span><span class="p">,</span> <span class="n">sigma_1</span><span class="p">,</span> <span class="n">sigma_2</span><span class="p">,</span> <span class="n">theta_0</span><span class="p">,</span> <span class="n">theta_1</span><span class="p">):</span>
    <span class="n">Sigma</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([[</span><span class="n">sigma_1</span><span class="p">,</span> <span class="mi">0</span><span class="p">],</span> <span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">sigma_2</span><span class="p">]])</span>
    <span class="n">epsilon</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">multivariate_normal</span><span class="p">([</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">Sigma</span><span class="p">,</span> <span class="n">N</span><span class="p">)</span>

    <span class="n">x</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">rand</span><span class="p">(</span><span class="n">N</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
    <span class="n">y</span> <span class="o">=</span> <span class="n">theta_0</span> <span class="o">+</span> <span class="n">x</span> <span class="o">@</span> <span class="n">theta_1</span><span class="p">.</span><span class="n">T</span> <span class="o">+</span> <span class="n">epsilon</span>
    <span class="k">return</span> <span class="n">x</span><span class="p">,</span> <span class="n">y</span>


<span class="k">def</span> <span class="nf">plot_figs</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">):</span>
    <span class="n">N</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">fig</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">4</span><span class="p">,</span> <span class="mi">4</span><span class="p">))</span>
    <span class="n">subfigs</span> <span class="o">=</span> <span class="n">fig</span><span class="p">.</span><span class="n">subfigures</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">wspace</span><span class="o">=</span><span class="mf">0.1</span><span class="p">)</span>

    <span class="n">axs_left</span> <span class="o">=</span> <span class="n">subfigs</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">subplots</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">subfigs</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">suptitle</span><span class="p">(</span><span class="s">"input x"</span><span class="p">)</span>
    <span class="n">axs_left</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">plot</span><span class="p">(</span><span class="nb">range</span><span class="p">(</span><span class="n">N</span><span class="p">),</span> <span class="n">x</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.6</span><span class="p">)</span>
    <span class="n">axs_left</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">set_ylabel</span><span class="p">(</span><span class="s">"x1"</span><span class="p">)</span>
    <span class="n">axs_left</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span>
    <span class="n">axs_left</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">plot</span><span class="p">(</span><span class="nb">range</span><span class="p">(</span><span class="n">N</span><span class="p">),</span> <span class="n">x</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.6</span><span class="p">)</span>
    <span class="n">axs_left</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">set_ylabel</span><span class="p">(</span><span class="s">"x2"</span><span class="p">)</span>
    <span class="n">axs_left</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">set_xlabel</span><span class="p">(</span><span class="s">"Sample index"</span><span class="p">)</span>
    <span class="n">axs_left</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span>
    
    <span class="n">axs_right</span> <span class="o">=</span> <span class="n">subfigs</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">subplots</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">subfigs</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">suptitle</span><span class="p">(</span><span class="s">"output y"</span><span class="p">)</span>
    <span class="n">axs_right</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">plot</span><span class="p">(</span><span class="nb">range</span><span class="p">(</span><span class="n">N</span><span class="p">),</span> <span class="n">y</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.6</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"C1"</span><span class="p">)</span>
    <span class="n">axs_right</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">set_ylabel</span><span class="p">(</span><span class="s">"y1"</span><span class="p">)</span>
    <span class="n">axs_right</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span>
    <span class="n">axs_right</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">plot</span><span class="p">(</span><span class="nb">range</span><span class="p">(</span><span class="n">N</span><span class="p">),</span> <span class="n">y</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.6</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"C1"</span><span class="p">)</span>
    <span class="n">axs_right</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">set_ylabel</span><span class="p">(</span><span class="s">"y2"</span><span class="p">)</span>
    <span class="n">axs_right</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">set_xlabel</span><span class="p">(</span><span class="s">"Sample index"</span><span class="p">)</span>
    <span class="n">axs_right</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span>

    <span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>


<span class="k">def</span> <span class="nf">est_ols_param</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">):</span>
    <span class="n">N</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>

    <span class="c1"># 构造设计矩阵 X_design: [1, x1, x2] for each sample
</span>    <span class="n">X_design</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">hstack</span><span class="p">([</span><span class="n">np</span><span class="p">.</span><span class="n">ones</span><span class="p">((</span><span class="n">N</span><span class="p">,</span> <span class="mi">1</span><span class="p">)),</span> <span class="n">x</span><span class="p">])</span>

    <span class="c1"># OLS估计: theta_hat = (X^T X)^{-1} X^T y
</span>    <span class="n">theta_hat</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">inv</span><span class="p">(</span><span class="n">X_design</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">X_design</span><span class="p">)</span> <span class="o">@</span> <span class="n">X_design</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">y</span>

    <span class="c1"># 提取估计的参数
</span>    <span class="n">theta_0_hat</span> <span class="o">=</span> <span class="n">theta_hat</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:]</span>
    <span class="n">theta_1_hat</span> <span class="o">=</span> <span class="n">theta_hat</span><span class="p">[</span><span class="mi">1</span><span class="p">:,</span> <span class="p">:].</span><span class="n">T</span>

    <span class="c1"># 计算Fisher信息矩阵和CRLB
</span>    <span class="c1"># 计算残差
</span>    <span class="n">y_pred</span> <span class="o">=</span> <span class="n">X_design</span> <span class="o">@</span> <span class="n">theta_hat</span>
    <span class="n">residuals</span> <span class="o">=</span> <span class="n">y</span> <span class="o">-</span> <span class="n">y_pred</span>
    
    <span class="c1"># 估计噪声协方差矩阵 Sigma_hat
</span>    <span class="n">Sigma_hat</span> <span class="o">=</span> <span class="p">(</span><span class="n">residuals</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">residuals</span><span class="p">)</span> <span class="o">/</span> <span class="n">N</span>
    
    <span class="c1"># 计算 Sigma 的逆矩阵
</span>    <span class="n">Sigma_inv</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">inv</span><span class="p">(</span><span class="n">Sigma_hat</span><span class="p">)</span>
    
    <span class="c1"># 计算 X^T X
</span>    <span class="n">XTX</span> <span class="o">=</span> <span class="n">X_design</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">X_design</span>
    
    <span class="c1"># 计算Fisher信息矩阵
</span>    <span class="c1"># Fisher_info = (X^T X) ⊗ Sigma^{-1}
</span>    <span class="n">Fisher_info</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">kron</span><span class="p">(</span><span class="n">XTX</span><span class="p">,</span> <span class="n">Sigma_inv</span><span class="p">)</span>
    
    <span class="c1"># 计算CRLB (Cramér-Rao Lower Bound)
</span>    <span class="n">CRLB</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">inv</span><span class="p">(</span><span class="n">Fisher_info</span><span class="p">)</span>
    
    <span class="c1"># 提取参数标准差（对角线元素的平方根）
</span>    <span class="n">param_std</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">sqrt</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">diag</span><span class="p">(</span><span class="n">CRLB</span><span class="p">))</span>

    <span class="k">return</span> <span class="n">theta_0_hat</span><span class="p">,</span> <span class="n">theta_1_hat</span><span class="p">,</span> <span class="n">param_std</span>
</code></pre></div></div>

<p>生成样本</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">theta_0</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">])</span>
<span class="n">theta_1</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">],</span> <span class="p">[</span><span class="mi">3</span><span class="p">,</span> <span class="mi">4</span><span class="p">]])</span>

<span class="n">N</span> <span class="o">=</span> <span class="mi">1000</span>
<span class="n">sigma_1</span> <span class="o">=</span> <span class="mf">0.1</span>
<span class="n">sigma_2</span> <span class="o">=</span> <span class="mf">0.1</span>

<span class="c1"># 生成样本
</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span> <span class="o">=</span> <span class="n">gen_samples</span><span class="p">(</span><span class="n">N</span><span class="p">,</span> <span class="n">sigma_1</span><span class="p">,</span> <span class="n">sigma_2</span><span class="p">,</span> <span class="n">theta_0</span><span class="p">,</span> <span class="n">theta_1</span><span class="p">)</span>
</code></pre></div></div>

<p>画图：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 画图
</span><span class="n">plot_figs</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>
</code></pre></div></div>

<p>基于OLS进行参数估计：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">theta_0_hat</span><span class="p">,</span> <span class="n">theta_1_hat</span><span class="p">,</span> <span class="n">param_std</span> <span class="o">=</span> <span class="n">est_ols_param</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>

<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"theta_0_hat = </span><span class="si">{</span><span class="n">theta_0_hat</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"theta_1_hat =</span><span class="se">\n</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"param_std = </span><span class="si">{</span><span class="n">param_std</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
</code></pre></div></div>

<h2 id="对比试验样本量对估计标准差的影响"><strong>对比试验：样本量对估计标准差的影响</strong></h2>

<p>接下来，分别对比不同样本量 $N = 100, 1000, 10000$ 时所得参数估计结果和标准差：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 完成代码,将结果整理为表格
</span><span class="n">results</span> <span class="o">=</span> <span class="p">[]</span>

<span class="k">for</span> <span class="n">N</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">100</span><span class="p">,</span> <span class="mi">1000</span><span class="p">,</span> <span class="mi">10000</span><span class="p">]:</span>
    <span class="n">x</span><span class="p">,</span> <span class="n">y</span> <span class="o">=</span> <span class="n">gen_samples</span><span class="p">(</span><span class="n">N</span><span class="p">,</span> <span class="n">sigma_1</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">sigma_2</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">theta_0</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">]),</span> <span class="n">theta_1</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">],</span> <span class="p">[</span><span class="mi">3</span><span class="p">,</span> <span class="mi">4</span><span class="p">]]))</span>
    <span class="n">theta_0_hat</span><span class="p">,</span> <span class="n">theta_1_hat</span><span class="p">,</span> <span class="n">param_std</span> <span class="o">=</span> <span class="n">est_ols_param</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>
    <span class="n">results</span><span class="p">.</span><span class="n">append</span><span class="p">({</span>
        <span class="s">"N"</span><span class="p">:</span> <span class="n">N</span><span class="p">,</span>
        <span class="s">"θ₀₁"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_0_hat</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₀₂"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_0_hat</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₁₁"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₁₂"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₂₁"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₂₂"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₀₁)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₀₂)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₁₁)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₁₂)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">3</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₂₁)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">4</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₂₂)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">5</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span>
    <span class="p">})</span>

<span class="n">df_results</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">)</span>
<span class="n">df_results</span>
</code></pre></div></div>

<p>可见，增加样本量能够显著降低参数估计的标准差，提高估计的精度。</p>

<h2 id="对比试验噪声对估计标准差的影响"><strong>对比试验：噪声对估计标准差的影响</strong></h2>

<p>对比 $y_1$ 通道上加入不同强度噪声 $\sigma_1 = 0.001, 0.1, 1$ 对参数估计标准差的影响：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 完成代码,将结果整理为表格
</span><span class="n">results_noise</span> <span class="o">=</span> <span class="p">[]</span>

<span class="k">for</span> <span class="n">sigma</span> <span class="ow">in</span> <span class="p">[</span><span class="mf">0.001</span><span class="p">,</span> <span class="mf">0.1</span><span class="p">,</span> <span class="mi">1</span><span class="p">]:</span>
    <span class="n">x</span><span class="p">,</span> <span class="n">y</span> <span class="o">=</span> <span class="n">gen_samples</span><span class="p">(</span><span class="n">N</span><span class="o">=</span><span class="mi">10000</span><span class="p">,</span> <span class="n">sigma_1</span><span class="o">=</span><span class="n">sigma</span><span class="p">,</span> <span class="n">sigma_2</span><span class="o">=</span><span class="n">sigma_2</span><span class="p">,</span> <span class="n">theta_0</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">]),</span> <span class="n">theta_1</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">],</span> <span class="p">[</span><span class="mi">3</span><span class="p">,</span> <span class="mi">4</span><span class="p">]]))</span>
    <span class="n">theta_0_hat</span><span class="p">,</span> <span class="n">theta_1_hat</span><span class="p">,</span> <span class="n">param_std</span> <span class="o">=</span> <span class="n">est_ols_param</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>
    <span class="n">results_noise</span><span class="p">.</span><span class="n">append</span><span class="p">({</span>
        <span class="s">"σ"</span><span class="p">:</span> <span class="n">sigma</span><span class="p">,</span>
        <span class="s">"θ₀₁"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_0_hat</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₀₂"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_0_hat</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₁₁"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₁₂"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₂₁"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"θ₂₂"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">theta_1_hat</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₀₁)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₀₂)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₁₁)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₁₂)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">3</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₂₁)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">4</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span><span class="p">,</span>
        <span class="s">"std(θ₂₂)"</span><span class="p">:</span> <span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">param_std</span><span class="p">[</span><span class="mi">5</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">g</span><span class="si">}</span><span class="s">"</span>
    <span class="p">})</span>

<span class="n">df_results_noise</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">(</span><span class="n">results_noise</span><span class="p">)</span>
<span class="n">df_results_noise</span>
</code></pre></div></div>

<p>从上述结果可见，当样本量充足时，输出 $y_1$ 通道上的噪声标准差越大，与该通道有关的参数估计结果的标准差也越大，而其他通道估计结果几乎不受影响。</p>

<hr />

<h2 id="附录"><strong>附录</strong></h2>

<table>
  <tbody>
    <tr>
      <td>假设 $\epsilon \sim N(0, \sigma^2)$，则 $Y_i</td>
      <td>X_i \sim N(X_i^T \theta, \sigma^2)$，对应的对数似然函数为：</td>
    </tr>
  </tbody>
</table>

\[\ell(\theta) = -\frac{n}{2} \log(2\pi\sigma^2) - \frac{1}{2\sigma^2} \sum_{i=1}^n (Y_i - X_i^T \theta)^2\]

<p>在固定的 $\sigma^2$ 下，最大化对数似然函数等价于最小化残差平方和，即：</p>

\[\arg\min_{\theta} \sum_{i=1}^n (Y_i - X_i^T \theta)^2\]

<p>因此，对于线性模型，如果误差项服从正态分布，则OLS估计量等价于MLE估计量。</p>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[克拉美罗下界（Cramér-Rao Lower Bound, CRLB）是系统辨识里的重要概念，用于衡量参数估计的下界精度。]]></summary></entry><entry><title type="html">多尺度时序因果分析</title><link href="https://ulti-dreisteine.github.io/academicpages/%E5%A4%9A%E5%B0%BA%E5%BA%A6%E6%97%B6%E5%BA%8F%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90/" rel="alternate" type="text/html" title="多尺度时序因果分析" /><published>2026-05-25T00:00:00+00:00</published><updated>2026-05-25T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/%E5%A4%9A%E5%B0%BA%E5%BA%A6%E6%97%B6%E5%BA%8F%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/%E5%A4%9A%E5%B0%BA%E5%BA%A6%E6%97%B6%E5%BA%8F%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90/"><![CDATA[<p>如何从时序信号数据中准确识别与目标变化相关的驱动因子，进而构建更加精简、可解释的预测模型，是时序分析领域的一个重要研究课题。本文将介绍一种基于<mark>符号化分解</mark>的<mark>多尺度时序因果分析方法</mark>，旨在帮助读者理解如何从时序数据中有效提取时序因果关系信息。</p>

<hr />

<h2 id="一多尺度时序作用案例">一、多尺度时序作用案例</h2>

<p>设计如下图所示的案例：</p>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%A4%9A%E5%B0%BA%E5%BA%A6%E6%97%B6%E5%BA%8F%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90/%E5%9B%BE1_%E8%80%A6%E5%90%88%E7%B3%BB%E7%BB%9F%E6%A1%88%E4%BE%8B%E5%9B%BE.png" width="700" />
</div>

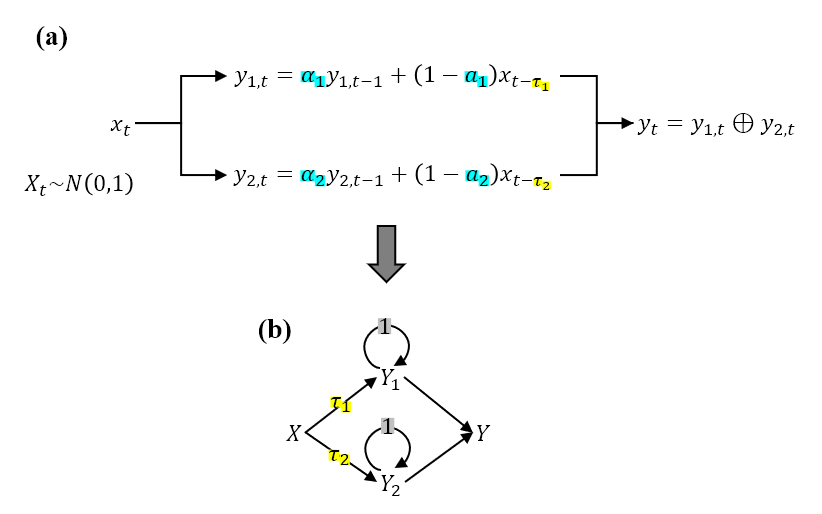
<p>图(a)展示了信号间的时序计算关系。其中，$t$ 表示时刻，信号源 $X$ 是一个均值为 0、标准差为 1 的高斯白噪声。$X$ 分别以不同的强度 $1-a_1$、$1-a_2$ 和滞后 $\tau_1$、$\tau_2$ 影响 $Y_1$ 和 $Y_2$。此外， $Y_1$ 和 $Y_2$ 还分别受到由 $a_1$、$a_2$ 调控的上一时刻状态的影响，具有不同时间尺度的自相关特性。最终，$Y_1$ 和 $Y_2$ 通过融合形成总输出 $Y$。这样一来， $Y$ 中包含了来自 $X$ 的不同滞后和时间尺度的信息，换言之，$X$ 对 $Y$ 具有多尺度多滞后的时序因果作用。</p>

<p>图(b)展示了对应于图(a)的变量因果作用有向图，箭头上的符号数字表示作用滞后。各信号值计算式如下：</p>

\[\begin{align*}
X_t &amp; \sim \mathcal{N}(\mu=0, \sigma=1) \\
Y_{1,t} &amp; = a_1Y_{1,t-1} + (1-a_1)X_{t-\tau_1} \\
Y_{2,t} &amp; = a_2Y_{2,t-1} + (1-a_2)X_{t-\tau_2} \\
Y_t &amp; = Y_{1,t} \oplus Y_{2,t}
\end{align*}\]

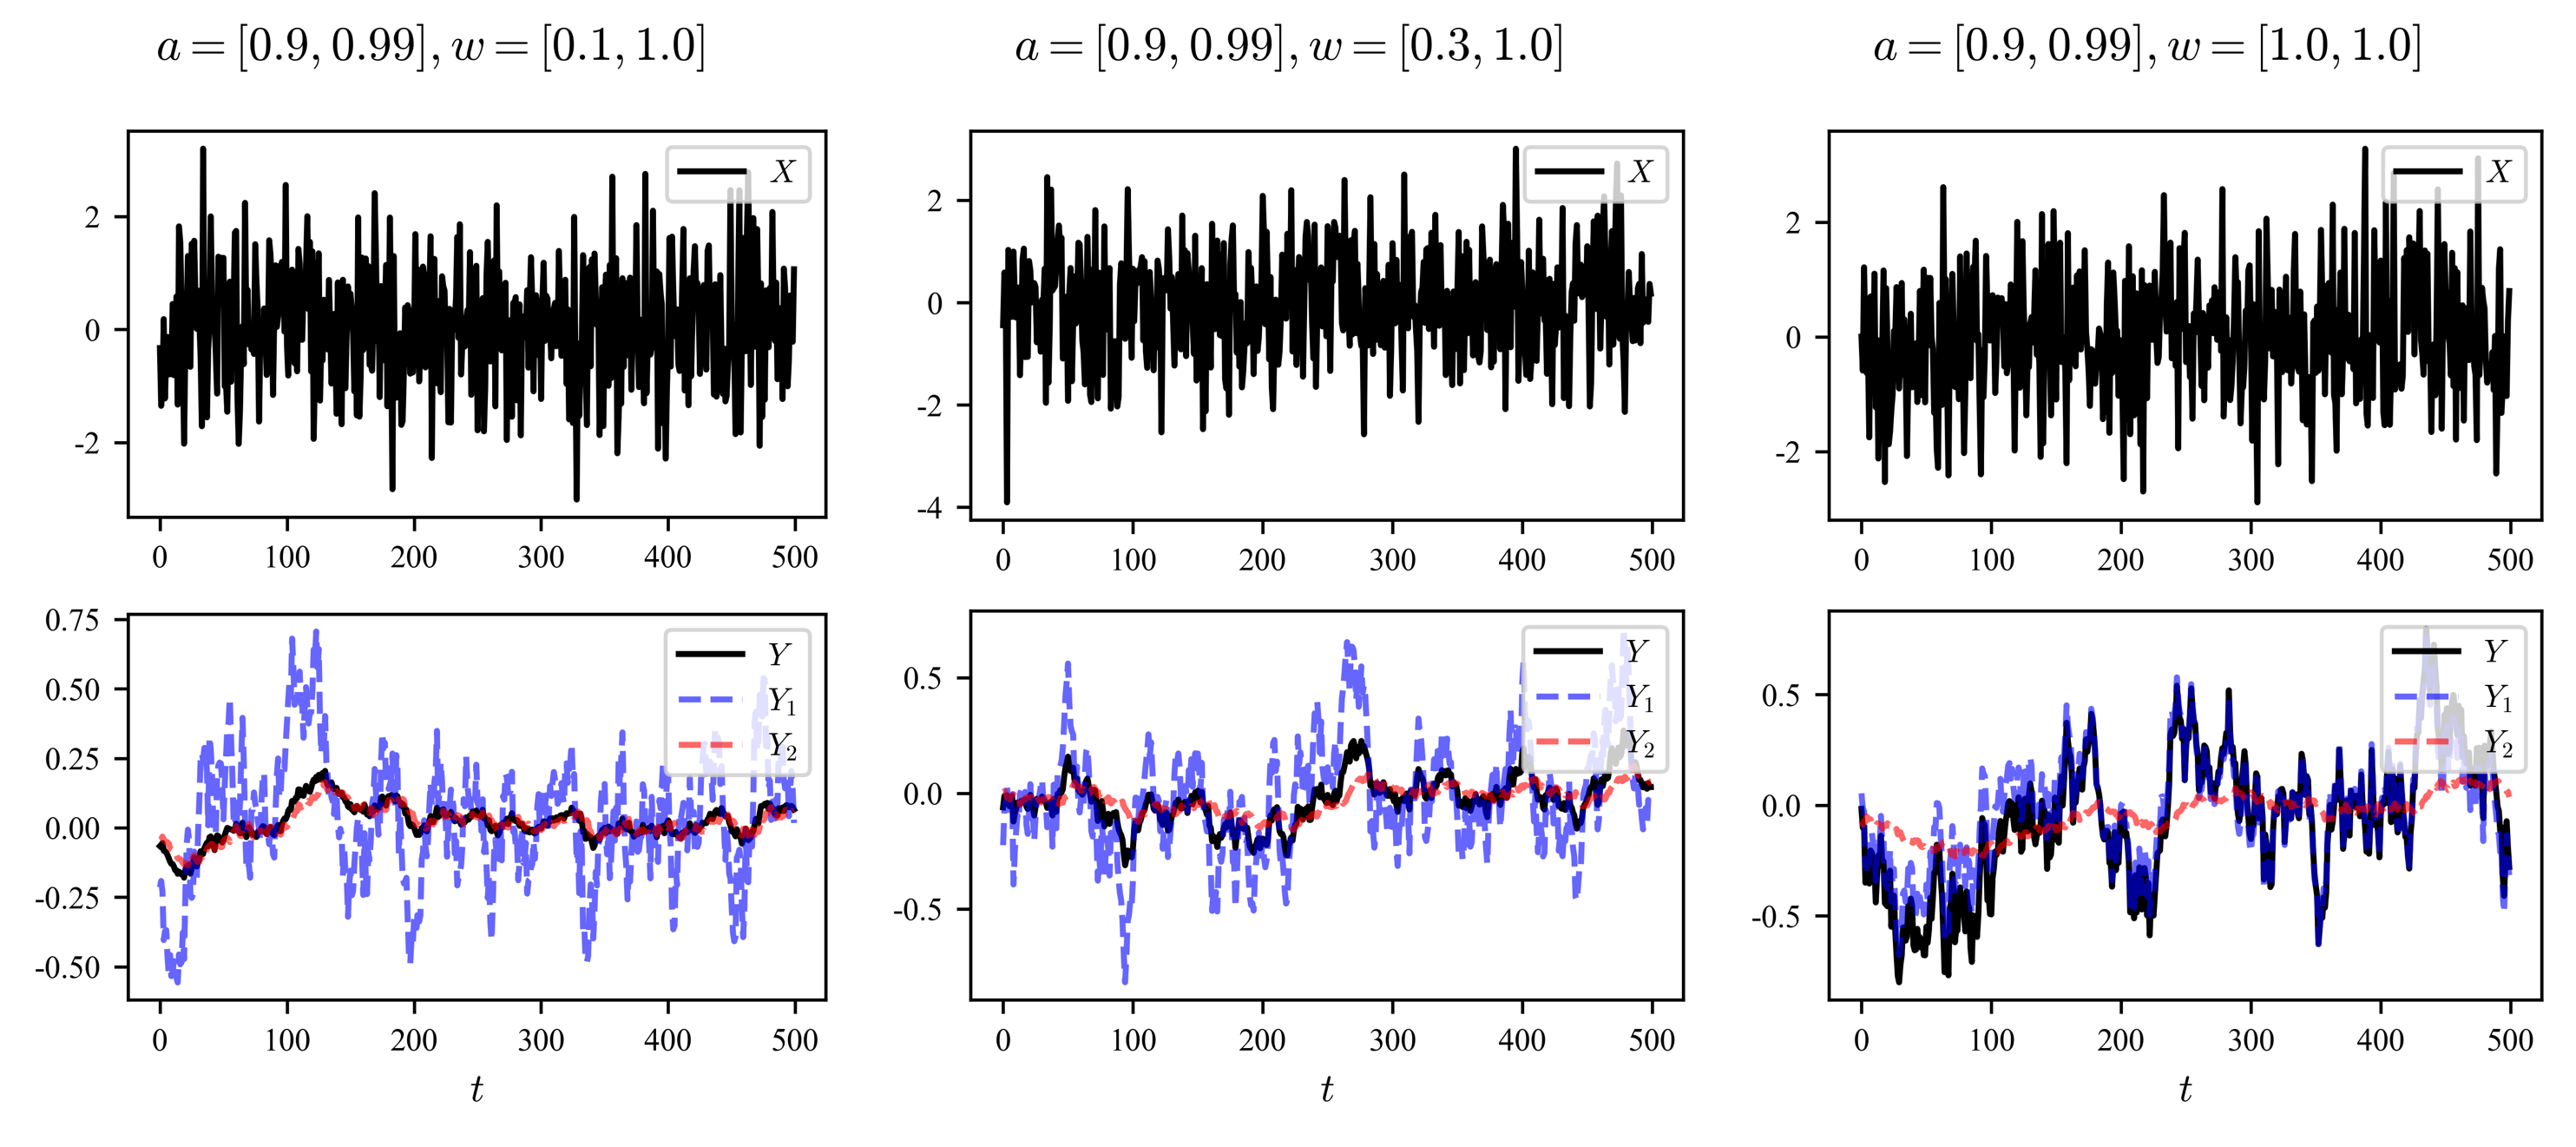
<p>式中 $\oplus$ 表示信号融合操作，在本文中将采用 $w_1$、$w_2$ 对 $Y_1$、$Y_2$ 加权求和的方式：$Y_t = w_1 Y_{1,t} + w_2 Y_{2,t}$，后续讨论将表明：<mark>不同权重分配将影响最终输出 $Y$ 中的主导信号特征，进而对因果分析结果产生影响</mark>。</p>

<p>下图分别显示了当 $a=[0.9, 0.99]$ 时，不断增加 $w_1$ 所得信号样本：</p>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%A4%9A%E5%B0%BA%E5%BA%A6%E6%97%B6%E5%BA%8F%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90/%E5%9B%BE2_%E4%B8%8D%E5%90%8C%E6%9D%83%E9%87%8D%E6%89%80%E5%BE%97%E7%9A%84%E4%BF%A1%E5%8F%B7%E6%A0%B7%E6%9C%AC.png" width="700" />
</div>

<p>可见，$Y_1$ 和 $Y_2$ 分别构成了 $Y$ 的高频和低频成分，随着 $w_1$ 的增加，$Y$ 中 $Y_1$ 的成分逐渐增强，最终主导了 $Y$ 的变化。</p>

<hr />

<h2 id="二非平稳序列的多尺度符号化分解">二、非平稳序列的多尺度符号化分解</h2>

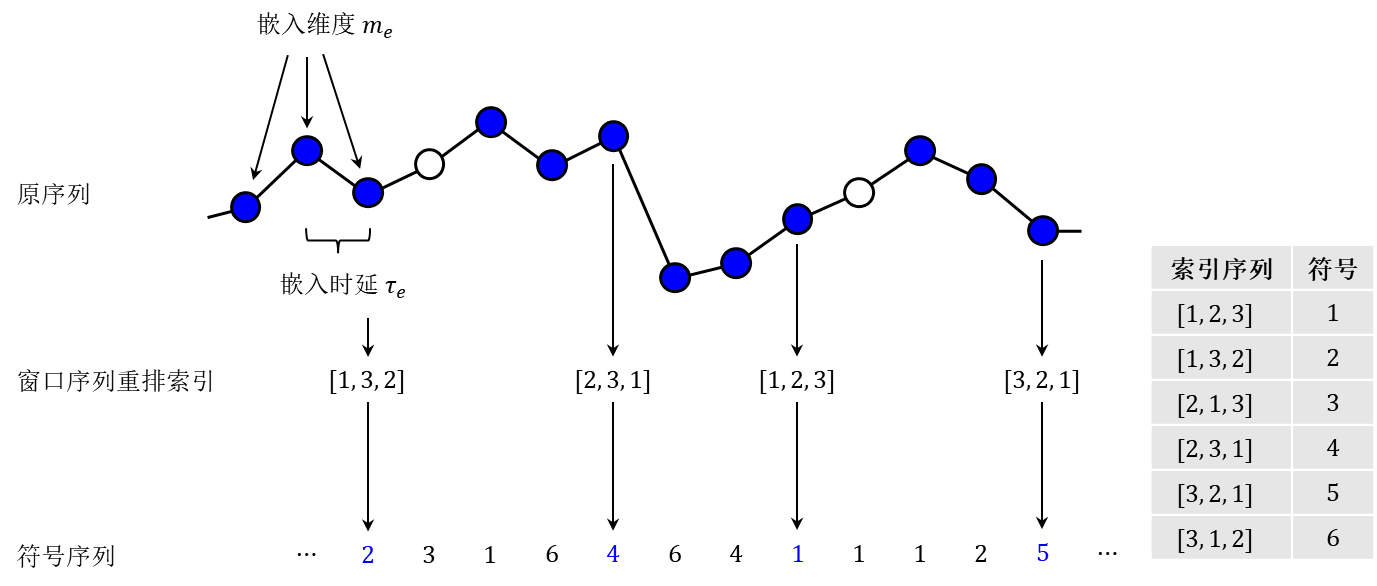
<p>采用符号化技术<sup id="fnref:1" role="doc-noteref"><a href="#fn:1" class="footnote" rel="footnote">1</a></sup>对<mark>一维平稳或非平稳</mark>的<mark>连续</mark>时序数据&lt;/mark&gt;进行编码分解，得到不同时间尺度上的<mark>离散</mark>符号序列，便于后续分析。序列的符号化原理如下所示：</p>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%A4%9A%E5%B0%BA%E5%BA%A6%E6%97%B6%E5%BA%8F%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90/%E5%9B%BE3_%E7%AC%A6%E5%8F%B7%E5%8C%96%E8%BD%AC%E6%8D%A2%E8%BF%87%E7%A8%8B.png" width="700" />
</div>

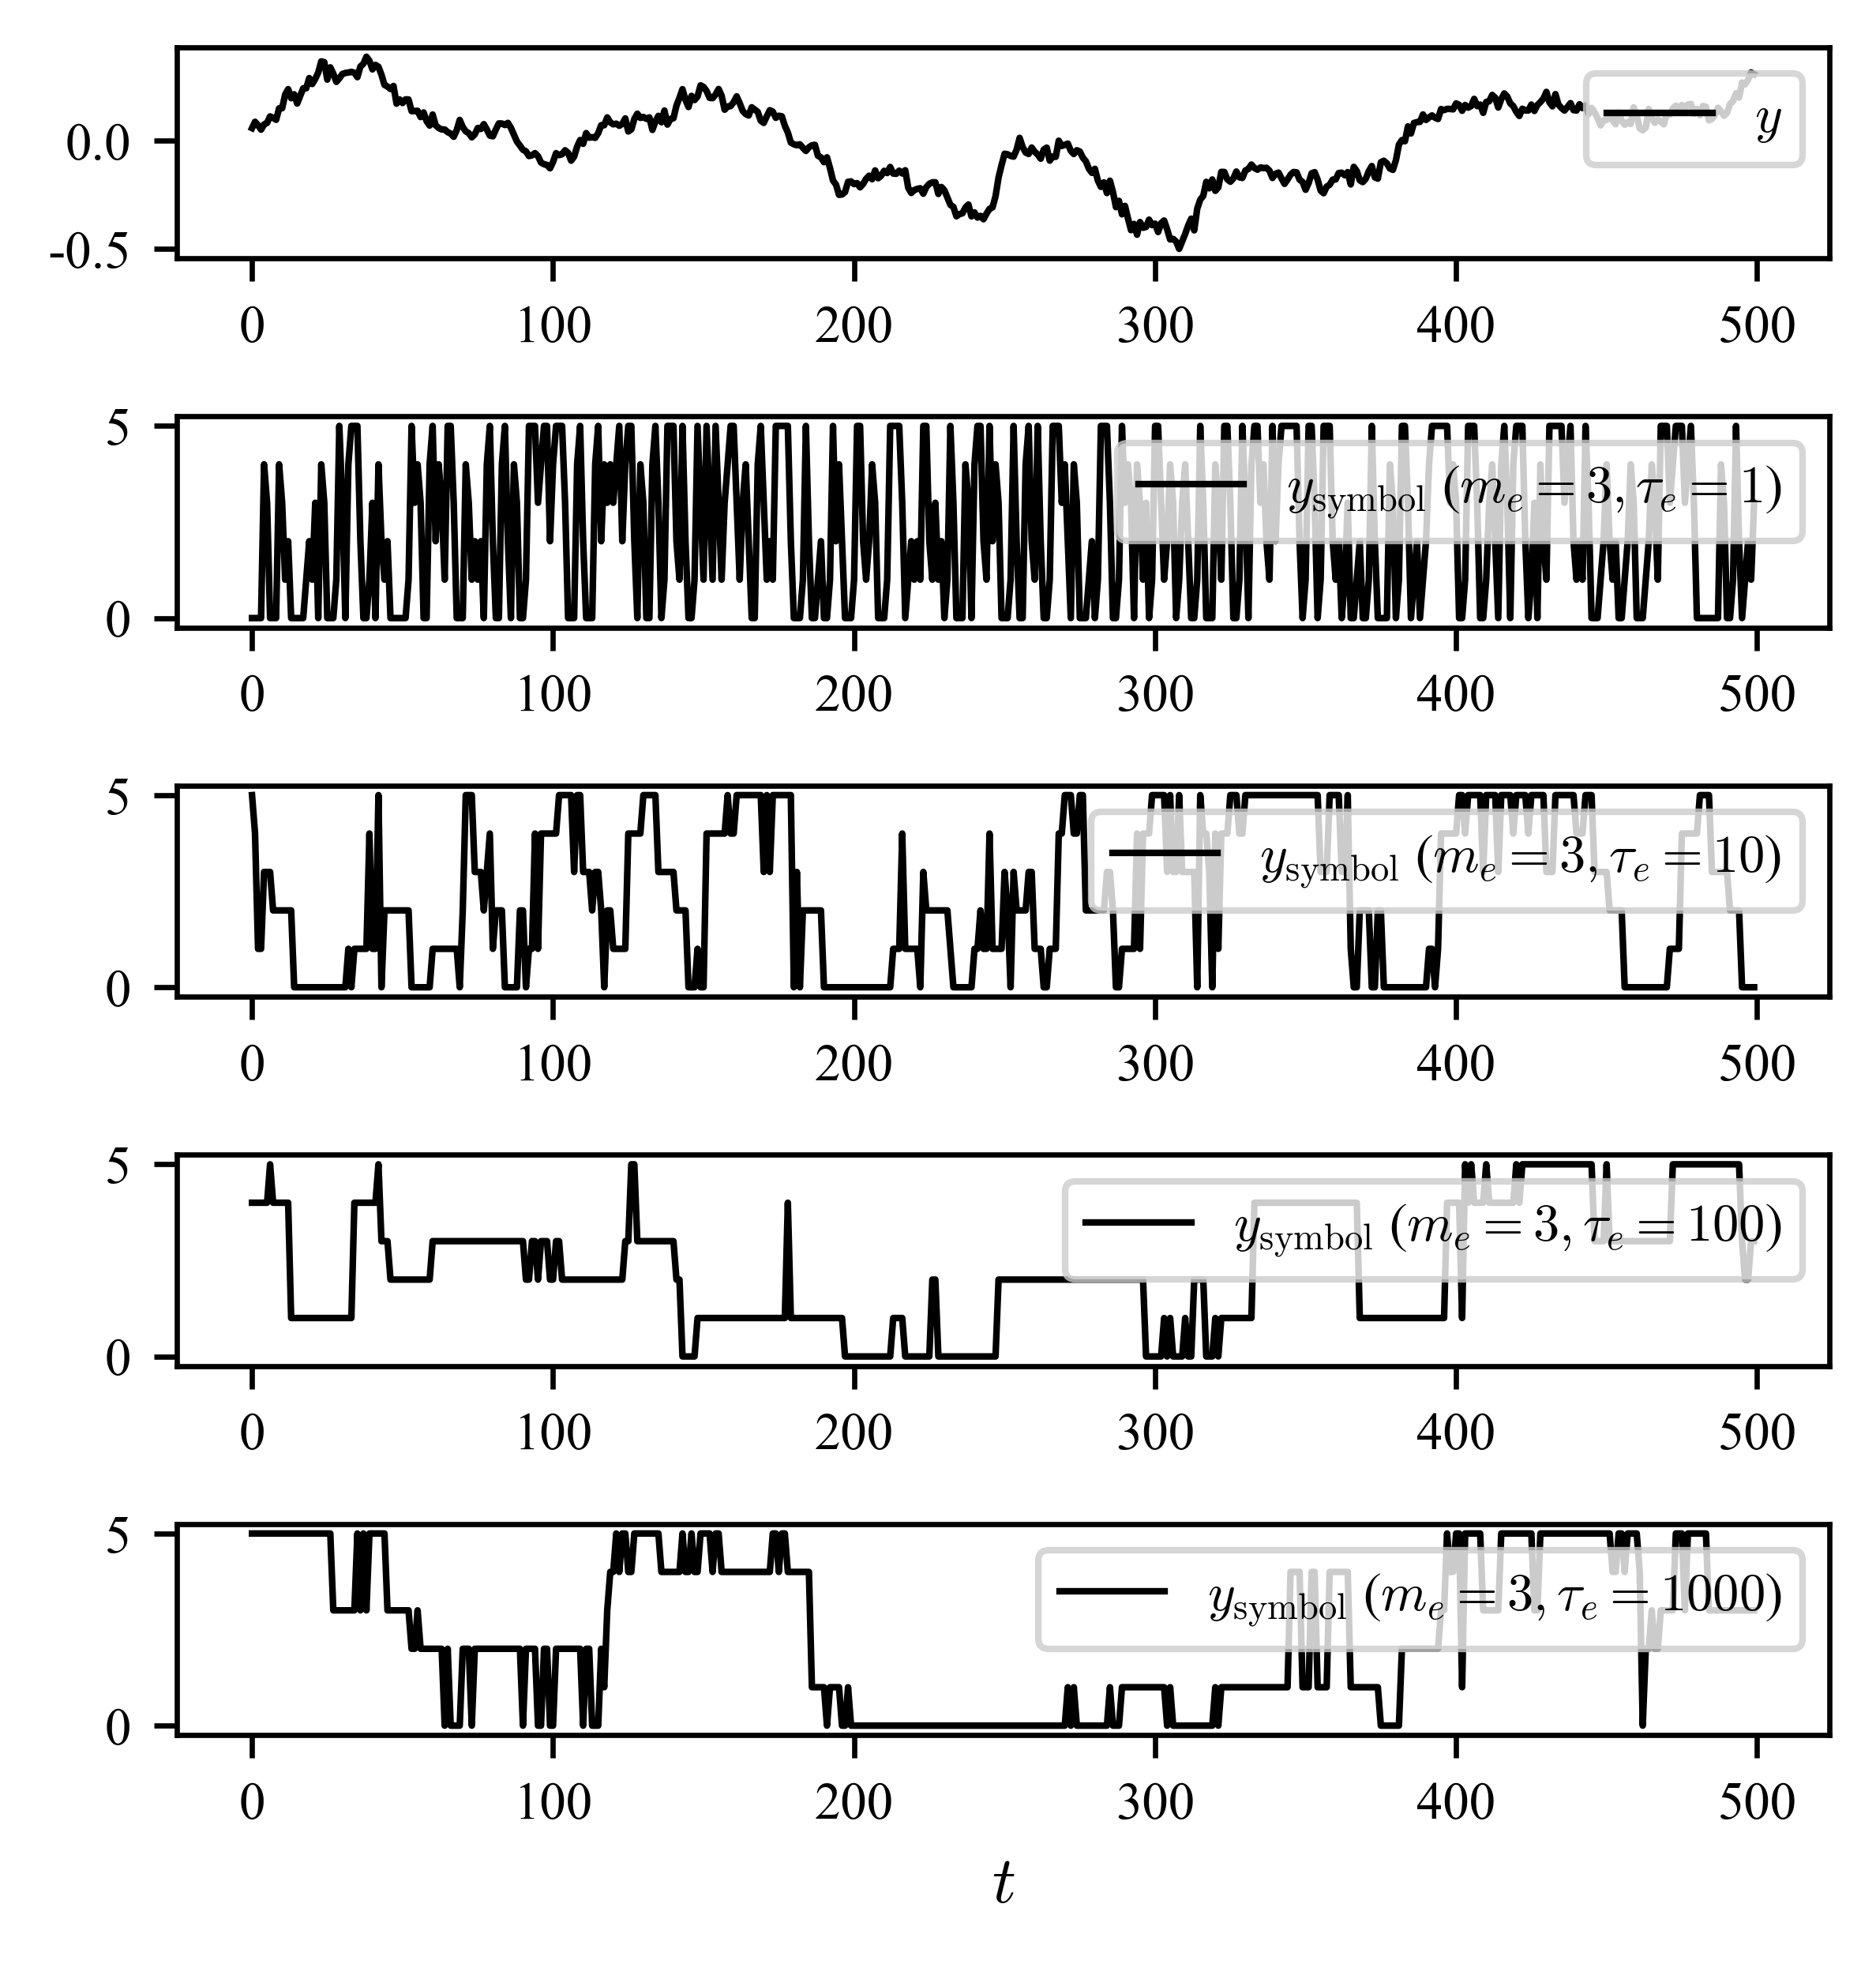
<p>关键参数为<mark>嵌入维度 $m_e$ </mark>（通常为3-5）和<mark>嵌入滞后 $\tau_e$ </mark>（$\tau_e$ 越小时间尺度越短，$\tau_e$ 越大时间尺度越长）。因此，在固定 $m_e$ 的情况下，从小到大设置 $\tau_e$ 进行符号化，便可将原始时序数据分解为不同时间尺度上的符号序列。每个符号序列的长度为 $N - (m_e-1)\tau$，其中 $N$ 为原始时序数据的长度。</p>

<p>下图展示了对 $Y$ 按照不同尺度参数进行符号化分解的示例，由于 $m_e=3$，离散后取得 $m_e! =6$ 种状态符号：</p>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%A4%9A%E5%B0%BA%E5%BA%A6%E6%97%B6%E5%BA%8F%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90/%E5%9B%BE4_%E5%A4%9A%E5%B0%BA%E5%BA%A6%E7%AC%A6%E5%8F%B7%E5%8C%96%E5%88%86%E8%A7%A3%E7%A4%BA%E4%BE%8B.png" width="700" />
</div>

<hr />

<h2 id="三多尺度时序因果分析">三、多尺度时序因果分析</h2>

<p>对 $X$ 和 $Y$ 序列数据进行多尺度分解，将结果代入时序因果分析算法进行计算，以探究其潜在的因果关系。设 $X$ 和 $Y$ 按照时间尺度 $\tau$ 分解后的符号序列分别为 $X^{(\tau)}$ 和 $Y^{(\tau)}$，采用<mark>动量信息传递（MIT, Momentum Information Transfer）</mark>算法<sup id="fnref:2" role="doc-noteref"><a href="#fn:2" class="footnote" rel="footnote">2</a></sup>对二者间的时序因果关系进行识别分析。</p>

<p>MIT算法源于传递熵（TE, Transfer Entropy）<sup id="fnref:3" role="doc-noteref"><a href="#fn:3" class="footnote" rel="footnote">3</a></sup>，但在计算过程中引入了因变量的额外历史状态作为条件集合，能够更好地捕捉时序数据中的因果关系和滞后效应。对于符号序列 $X^{(\tau)}$ 和 $Y^{(\tau)}$，TE和MIT的计算公式如下：</p>

\[\begin{align*}
I^{\rm TE}_{X \to Y}(\tau) &amp; = I(X_{t-\tau};Y_t|Y_{t-1}) \\
I^{\rm MIT}_{X \to Y}(\tau) &amp; = I(X_{t-\tau};Y_t|X_{t-\tau-1}, Y_{t-1}) \\
\end{align*}\]

<table>
  <tbody>
    <tr>
      <td>其中，$I(\cdot</td>
      <td>\cdot)$ 表示条件互信息，计算涉及<mark>概率估计</mark>和<mark>统计检验</mark>，细节参见文末参考资料，此处按下不表；$\tau$ 表示待检测的 $X\to Y$ 的滞后，如果 $X$ 对 $Y$ 具有显著的滞后因果作用，则TE和MIT的熵值将会在对应的滞后 $\tau$ 处呈现显著的峰值。</td>
    </tr>
  </tbody>
</table>

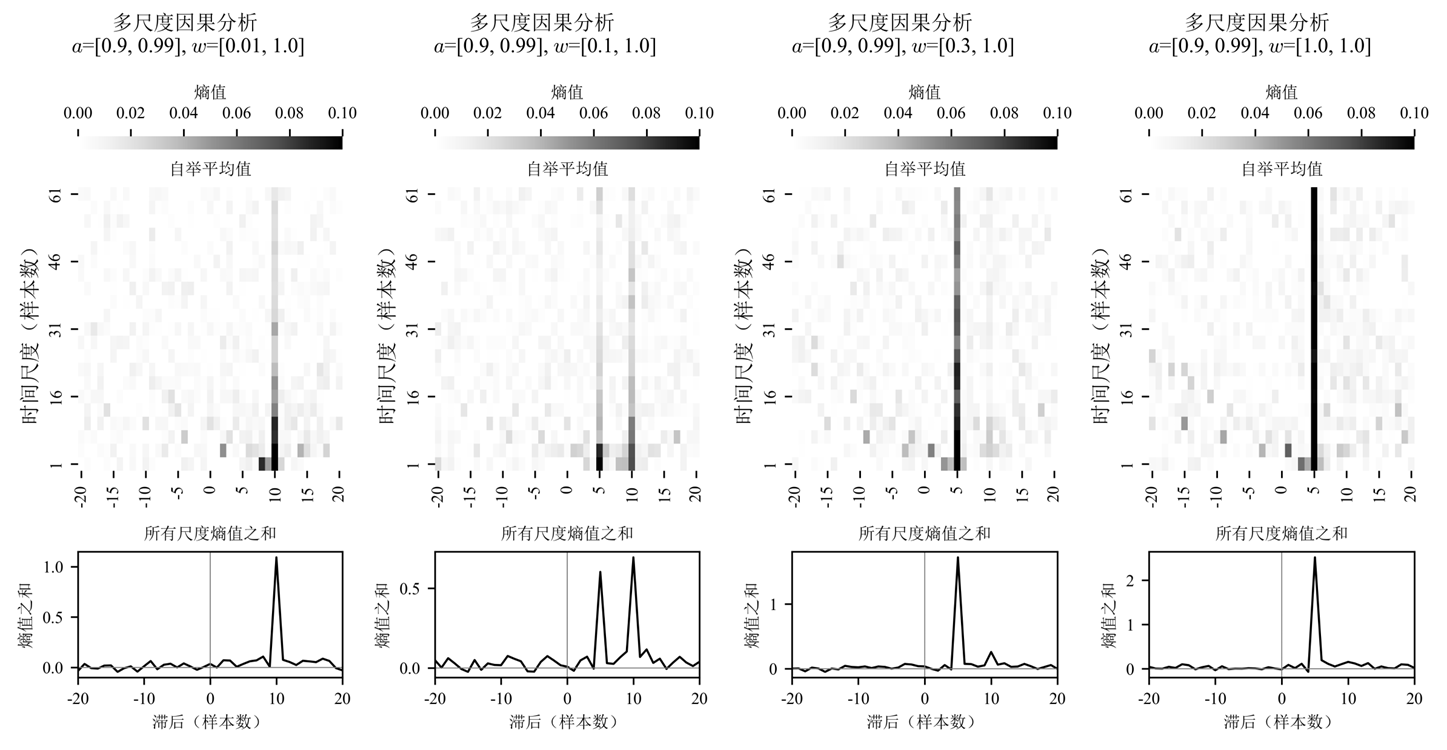
<p>下图显示了采用MIT对本文案例所述系统进行分析所得结果。分析采用Bootstrap自举方式从系统中循环地（100轮）抽取100个独立样本，然后汇总所有滞后上计算所得的MIT熵值和背景值（由置换检验获得），最终绘制MIT熵值随滞后和时间尺度的变化关系：</p>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%A4%9A%E5%B0%BA%E5%BA%A6%E6%97%B6%E5%BA%8F%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90/%E5%9B%BE5_%E5%A4%9A%E5%B0%BA%E5%BA%A6%E5%9B%A0%E6%9E%9C%E5%88%86%E6%9E%90%E7%BB%93%E6%9E%9C.png" width="700" />
</div>

<p>图中，从左往右，输出 $Y$ 中 $Y_1$ 信号权重逐渐增强，同时 $Y_2$ 信号权重不变：</p>
<ol>
  <li>当 $Y_1$ 信号权重很小（$w_1=0.01$）时（最左图），输出 $Y$ 中 $Y_2$ 占主导地位，MIT 算法仅能检测出 $X$ 对 $Y$ 在滞后 $\tau_2 = 10$ 处的因果作用；</li>
  <li>当 $Y_1$ 信号权重较大（$w_1\geq0.3$）时（最右两张图），输出 $Y$ 中 $Y_1$ 占主导地位，MIT 算法相应地只检测出 $X$ 对 $Y$ 在滞后 $\tau_1 = 5$ 处的因果作用；</li>
  <li>值得注意的是，只有当权重取中等值（$w_1=0.3$）时，MIT 算法才能同时检测出 $X$ 对 $Y$ 在 $\tau_1 = 5$ 和 $\tau_2 = 10$ 处的双重因果作用。此外，该图显示 $X$ 对 $Y_1$ 成分作用对应尺度比 $Y_2$ 更小。</li>
</ol>

<p>本案例中的多尺度现象只有在合适的权重设置下才会出现，<mark>并非普遍现象</mark>。</p>

<div class="footnotes" role="doc-endnotes">
  <ol>
    <li id="fn:1" role="doc-endnote">
      <p>M. Staniek and K. Lehnertz, “Symbolic Transfer Entropy”, Physical Review Letters, 2008. <a href="#fnref:1" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
    <li id="fn:2" role="doc-endnote">
      <p>B. Pompe and J. Runge, “Momentary information transfer as a coupling measure of time series”, Physical Review E, 2011. <a href="#fnref:2" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
    <li id="fn:3" role="doc-endnote">
      <p>T. Schreiber, “Measuring Information Transfer”, Physical Review Letters, 2000. <a href="#fnref:3" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
  </ol>
</div>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[如何从时序信号数据中准确识别与目标变化相关的驱动因子，进而构建更加精简、可解释的预测模型，是时序分析领域的一个重要研究课题。本文将介绍一种基于符号化分解的多尺度时序因果分析方法，旨在帮助读者理解如何从时序数据中有效提取时序因果关系信息。]]></summary></entry><entry><title type="html">小样本马尔可夫链独立性检验</title><link href="https://ulti-dreisteine.github.io/academicpages/%E5%B0%8F%E6%A0%B7%E6%9C%AC%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E7%8B%AC%E7%AB%8B%E6%80%A7%E6%A3%80%E9%AA%8C/" rel="alternate" type="text/html" title="小样本马尔可夫链独立性检验" /><published>2026-05-25T00:00:00+00:00</published><updated>2026-05-25T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/%E5%B0%8F%E6%A0%B7%E6%9C%AC%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E7%8B%AC%E7%AB%8B%E6%80%A7%E6%A3%80%E9%AA%8C</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/%E5%B0%8F%E6%A0%B7%E6%9C%AC%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E7%8B%AC%E7%AB%8B%E6%80%A7%E6%A3%80%E9%AA%8C/"><![CDATA[<p>本文主要包括以下内容：</p>
<ol>
  <li>案例构建和样本采集</li>
  <li>小样本量下的独立性检验</li>
</ol>

<h2 id="一案例构建和样本采集">一、案例构建和样本采集</h2>

<p>假定有两个独立的骰子 $X$ 和 $Y$，每个骰子有6个面。独立重复 $N_{\text{trails}}$ 次掷骰子试验，每次试验持续较少的 $N_{\text{steps}}$ 步（即小样本量）。分别记录第i次试验的第j步骰子结果为 $x_{i,j}$ 和 $y_{i,j}$。最终获得样本数组 $X_{N_{\text{trails}}×N_{\text{steps}}}$ 和 $Y_{N_{\text{trails}}×N_{\text{steps}}}$ 用于分析。</p>

<p>在本案例中，使用状态转移矩阵 $\pi$ 控制骰子 $X$ 和 $Y$ 各自的点数变化。</p>

<p><strong>状态转移矩阵性质：</strong></p>
<ul>
  <li>每个元素 $π_{i,j} \geq 0$ 表示从当前状态 $i$ 转移到下个状态 $j$ 的概率</li>
  <li>$\boldsymbol{\pi}$ 的每一行之和必为1</li>
  <li>骰子点数为1至6，状态空间维数为6</li>
  <li>$\boldsymbol{\pi}$ 为 $6 \times 6$ 的矩阵</li>
</ul>

<p><strong>独立投掷的状态转移矩阵：</strong></p>

\[\boldsymbol{\pi} = \frac{1}{6} \cdot \mathbf{1}_{6 \times 6}\]

<p><strong>1阶投掷的状态转移矩阵：</strong></p>

\[\boldsymbol{\pi} = \begin{bmatrix}
0.5   &amp; 0.25 &amp; 0    &amp; 0    &amp; 0    &amp; 0.25 \\
0.25  &amp; 0.5  &amp; 0.25 &amp; 0    &amp; 0    &amp; 0    \\
0     &amp; 0.25 &amp; 0.5  &amp; 0.25 &amp; 0    &amp; 0    \\
0     &amp; 0    &amp; 0.25 &amp; 0.5  &amp; 0.25 &amp; 0    \\
0     &amp; 0    &amp; 0    &amp; 0.25 &amp; 0.5  &amp; 0.25 \\
0.25  &amp; 0    &amp; 0    &amp; 0    &amp; 0.25 &amp; 0.5
\end{bmatrix}\]

<p><strong>2阶投掷的状态转移矩阵：</strong></p>

<p>对于任意历史状态 $(s_{t-2}, s_{t-1}) \in \mathcal{S}^2$：</p>

\[\pi(X_t \mid X_{t-2}, X_{t-1}) = \begin{cases}
[0.7, 0.2, 0.1] &amp; \text{if } (0,0) \\
[0.1, 0.6, 0.3] &amp; \text{if } (0,1) \\
[0.2, 0.2, 0.6] &amp; \text{if } (0,2) \\
[0.3, 0.4, 0.3] &amp; \text{if } (1,0) \\
[0.1, 0.8, 0.1] &amp; \text{if } (1,1) \\
[0.0, 0.1, 0.9] &amp; \text{if } (1,2) \\
[0.5, 0.5, 0.0] &amp; \text{if } (2,0) \\
[0.2, 0.3, 0.5] &amp; \text{if } (2,1) \\
[0.1, 0.1, 0.8] &amp; \text{if } (2,2)
\end{cases}\]

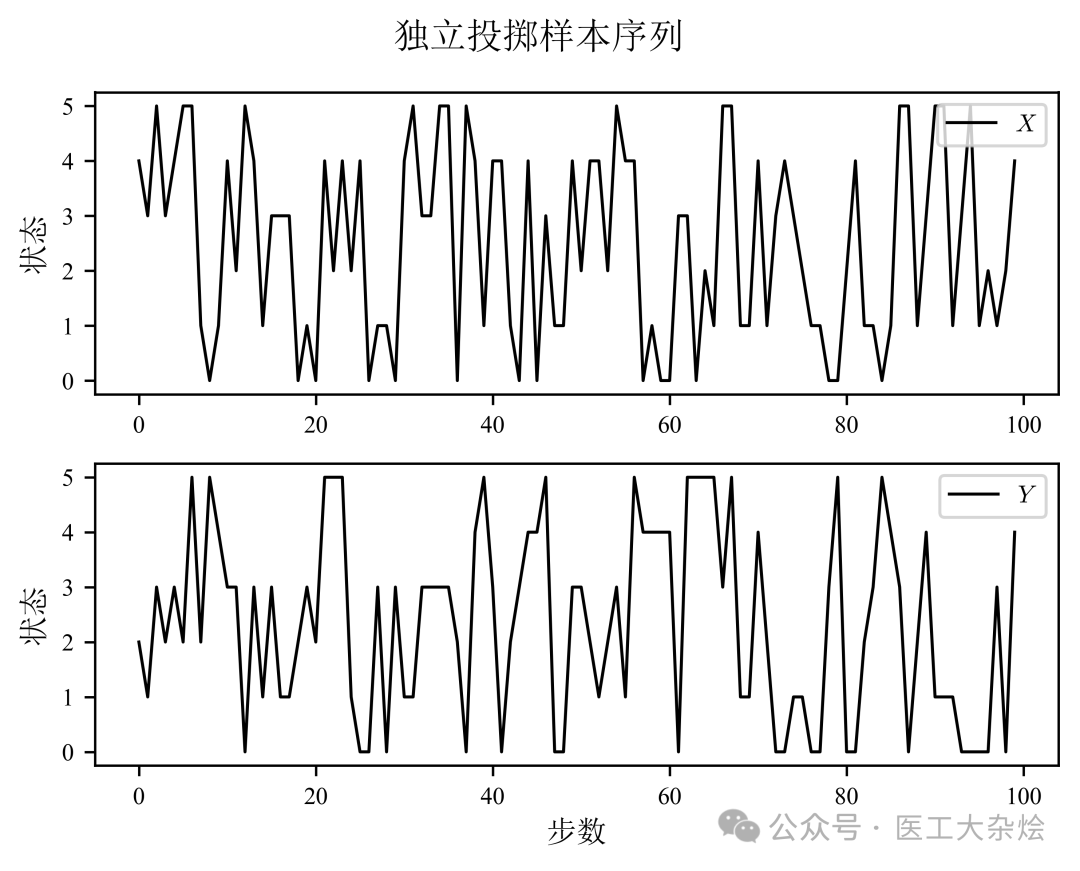
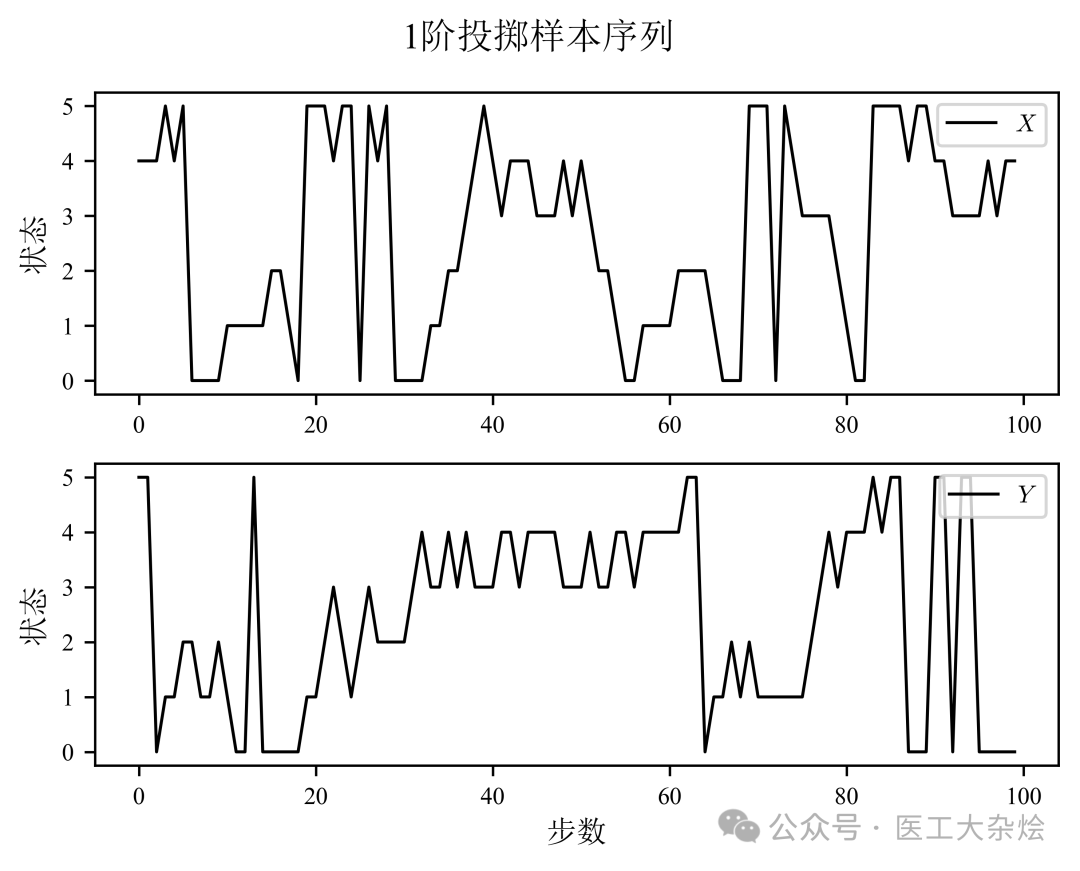
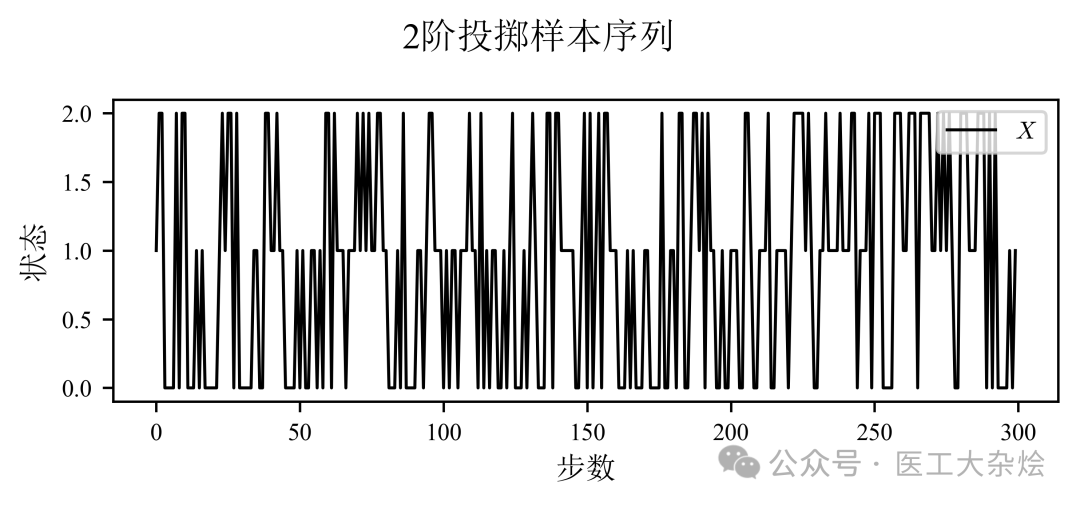
<p>对应样本变化曲线如下：</p>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%B0%8F%E6%A0%B7%E6%9C%AC%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E7%8B%AC%E7%AB%8B%E6%80%A7%E6%A3%80%E9%AA%8C/%E5%9B%BE1_%E7%8B%AC%E7%AB%8B%E6%8A%95%E6%8E%B7%E6%A0%B7%E6%9C%AC.png" width="700" />
</div>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%B0%8F%E6%A0%B7%E6%9C%AC%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E7%8B%AC%E7%AB%8B%E6%80%A7%E6%A3%80%E9%AA%8C/%E5%9B%BE2_1%E9%98%B6%E6%8A%95%E6%8E%B7%E6%A0%B7%E6%9C%AC.png" width="700" />
</div>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%B0%8F%E6%A0%B7%E6%9C%AC%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E7%8B%AC%E7%AB%8B%E6%80%A7%E6%A3%80%E9%AA%8C/%E5%9B%BE3_2%E9%98%B6%E6%8A%95%E6%8E%B7%E6%A0%B7%E6%9C%AC.png" width="700" />
</div>

<p>可见，随着阶数的增加，样本序列的变化趋势逐渐平缓。因此，可以通过设计状态转移的方式对每次试验的点数变化规律进行控制。需注意，由于骰子 $X$ 和 $Y$ 相互独立，不论状态转移矩阵如何设置，$X$ 和 $Y$ 试验所得样本都应无关。</p>

<p><span style="background-color: #fff8b0">本文研究：如何使用小样本，准确检验 $X$ 和 $Y$ 的独立性，并确定马尔可夫链的阶数。</span></p>

<hr />

<h2 id="二小样本量下的独立性检验">二、小样本量下的独立性检验</h2>

<h3 id="21-非马尔可夫链的独立性检验方法">2.1 非马尔可夫链的独立性检验方法</h3>

<p>如果 $X$ 和 $Y$ 的样本序列不具有马尔可夫性，则理论上在任意试验 $i$ 中，$X$ 和 $Y$ 应始终相互独立。因此，对每组样本 $x_{i}=\left[ x_{i,1},\cdots,x_{i,N_{\text{steps}}} \right]$ 和 $y_{i}=\left[ y_{i,1},\cdots,y_{i,N_{\text{steps}}} \right]$ 进行独立性检验时，结果应显示二者独立。需要注意的是，由于每次试验的步数 $N_{\text{steps}}$ 较少（实际应用中常见），必须确保在如此小样本量下，独立性检验结果依然具有可靠性。为此，置换检验和 Bootstrap 检验等非参数方法特别适合用于小样本量下复杂分布数据的独立性检验。具体而言，对于某一 $X$-$Y$ 联合分布（其来源不一定为马尔可夫链），通过独立同分布采样获得的样本 $x_{i}$ 和 $y_{i}$，可先计算互信息 $I(x_{i};y_{i})$ 以衡量其关联度，再通过置换检验进行判断：若 $I(x_{i};y_{i})$ 未显著大于 0（零假设 $H_{0}$），则接受 $X$ 与 $Y$ 无关的结论；反之，若显著大于 0（备择假设 $H_{1}$），则认为两者存在关联。</p>

<p>互信息是一种衡量随机变量间线性和非线性关联程度的指标，定义为：</p>

\[I(X;Y) = \sum_{x \in X} \sum_{y \in Y} p(x,y) \log \frac{p(x,y)}{p(x)p(y)} \tag{1}\]

<h4 id="211-排列置换检验">2.1.1 排列置换检验</h4>

<p>在零假设 $H_0$ 成立条件下（即 $X$ 和 $Y$ 样本来自同一总体），其组别标签可随机交换而不影响统计量分布。具体实施时：首先将原始样本合并为总集 $Z = X \cup Y = {z_1,\cdots,z_{N_X+N_Y}}$，随后进行 $N_{\text{perm}}$ 轮置换抽样，每轮从 $Z$ 中<span style="background-color: #fff8b0">无放回</span>抽取 $\lfloor(N_X+N_Y)/2\rfloor$ 个样本作为置换组 $X_k^{\text{perm}}$，剩余样本作为 $Y_k^{\text{perm}}$，并计算每轮的关联系数$I(X_k^{\text{perm}};Y_k^{\text{perm}})$；通过重复该过程构建经验分布函数</p>

\[F(t) = \frac{1}{N_{\text{perm}}}\sum_{k=1}^{N_{\text{perm}}} \mathbb{1}\left(I(X_k^{\text{perm}};Y_k^{\text{perm}}) \leq t\right) \tag{2}\]

<p>最终，结合样本实际观测值计算 $p$ 值，并与单边检验显著性水平 $\alpha$ 比较：</p>

\[p = \frac{\sum_{k=1}^{N_{\text{perm}}} \mathbb{1}\left(I(X_k^{\text{perm}};Y_k^{\text{perm}}) \geq I_{\text{obs}}\right)}{N_{\text{perm}}} \tag{3}\]

<p>若 $p \leq \alpha$，则拒绝零假设 $H_0$ 接受 $H_1$，认为 $X$ 和 $Y$ 之间存在显著关联。</p>

<h4 id="212-蒙特卡洛置换检验">2.1.2 蒙特卡洛置换检验</h4>

<p>蒙特卡洛置换检验提供了一种非参数的关联性分析方法，其流程与排列置换检验类似，但在各变量内部进行置换操作。对于一组 样本 $X$ 和 $Y$，首先计算其互信息 $I(X;Y)$。然后进行 $N_{\text{perm}}$ 次随机抽样，每次随机打乱 $X$ 顺序得到置换样本 $X_k^{\text{perm}}$，并计算互信息 $I(X_k^{\text{perm}};Y)$。最终通过多轮置换获得经验分布，计算 $p$ 值和显著性。</p>

\[F(t) = \frac{1}{N_{\text{perm}}}\sum_{k=1}^{N_{\text{perm}}} \mathbb{1}\left(I(X_k^{\text{perm}};Y) \leq t\right) \quad \tag{4}\]

\[p = \frac{\sum_{k=1}^{N_{\text{perm}}} \mathbb{1}\left(I(X_k^{\text{perm}};Y) \geq I_{\text{obs}}\right)}{N_{\text{perm}}} \tag{5}\]

<h4 id="213-bootstrap-检验">2.1.3 Bootstrap 检验</h4>

<p>Bootstrap 检验是一种基于重采样的非参数方法，适用于小样本量下的独立性检验。其基本思想是通过对原始样本进行<span style="background-color: #fff8b0">有放回抽样</span>，构建多个 Bootstrap 样本集，从而估计统计量的分布。对于一组样本 $X$ 和 $Y$，首先计算其互信息 $I(X;Y)$。然后进行 $N_{\text{bootstrap}}$ 次随机抽样，每次从 $X$ 中<span style="background-color: #fff8b0">有放回</span>地抽取 $N_X$ 个样本，得到 Bootstrap 样本 $X_k^{\text{bootstrap}}$。最终通过多轮 Bootstrap 抽样获得经验分布，计算 $p$ 值和显著性。</p>

\[F(t) = \frac{1}{N_{\text{bootstrap}}}\sum_{k=1}^{N_{\text{bootstrap}}} \mathbb{1}\left(I(X_k^{\text{bootstrap}};Y) \leq t\right) \quad \tag{6}\]

\[p = \frac{\sum_{k=1}^{N_{\text{bootstrap}}} \mathbb{1}\left(I(X_k^{\text{bootstrap}};Y) \geq I_{\text{obs}}\right)}{N_{\text{bootstrap}}} \tag{7}\]

<h3 id="22-马尔可夫链的独立性检验方法">2.2 马尔可夫链的独立性检验方法</h3>

<p>2.1节中介绍的3种方法均适用于非马尔可夫链的独立性检验。然而，当样本序列具有马尔可夫性时，序列具有时序性和马尔可夫性，直接随机打乱样本会破坏内部的时序结构和依赖关系，丢失本底关联信息，进而造成检验结果失真。因此，针对马尔可夫链的独立性检验，需要采用更复杂的检验方法。</p>

<p>2.1节方法用于马尔可夫链检验的问题主要在于零假设分布样本构建失真，需要采用如下的<span style="background-color: #fff8b0">保序替代样本</span>（order-preserving surrogates）构建方法：</p>
<ol>
  <li>设定变量数据的马尔可夫阶数 $k$，并基于原始序列 $X$ 估计状态转移矩阵$\hat{\boldsymbol{\pi}}$；</li>
  <li>利用估计的转移概率矩阵$\hat{\boldsymbol{\pi}}$，从 $X$ 的初始状态出发，随机生成保序替代样本 $X_{k}^{\text{surrog}}$，并计算其互信息 $I(X_{k}^{\text{surrog}};Y)$；</li>
  <li>重复步骤2，进行 $N_{\text{surrogates}}$ 次生成计算，得到保序替代样本互信息值的经验分布；</li>
</ol>

\[F(t) = \frac{1}{N_{\text{surrogates}}}\sum_{k=1}^{N_{\text{surrogates}}} \mathbb{1}\left(I(X_{k}^{\text{surrog}};Y) \leq t\right) \tag{8}\]

<ol>
  <li>计算原始样本的互信息 $I(X;Y)$，并与保序替代样本的经验分布进行比较，计算 $p$ 值和显著性。</li>
</ol>

\[p = \frac{\sum_{k=1}^{N_{\text{surrogates}}} \mathbb{1}\left(I(X_{k}^{\text{surrog}};Y) \geq I_{\text{obs}}\right)}{N_{\text{surrogates}}} \tag{9}\]

<h2 id="三案例分析">三、案例分析</h2>

<h3 id="31-独立投掷样本序列">3.1 独立投掷样本序列</h3>

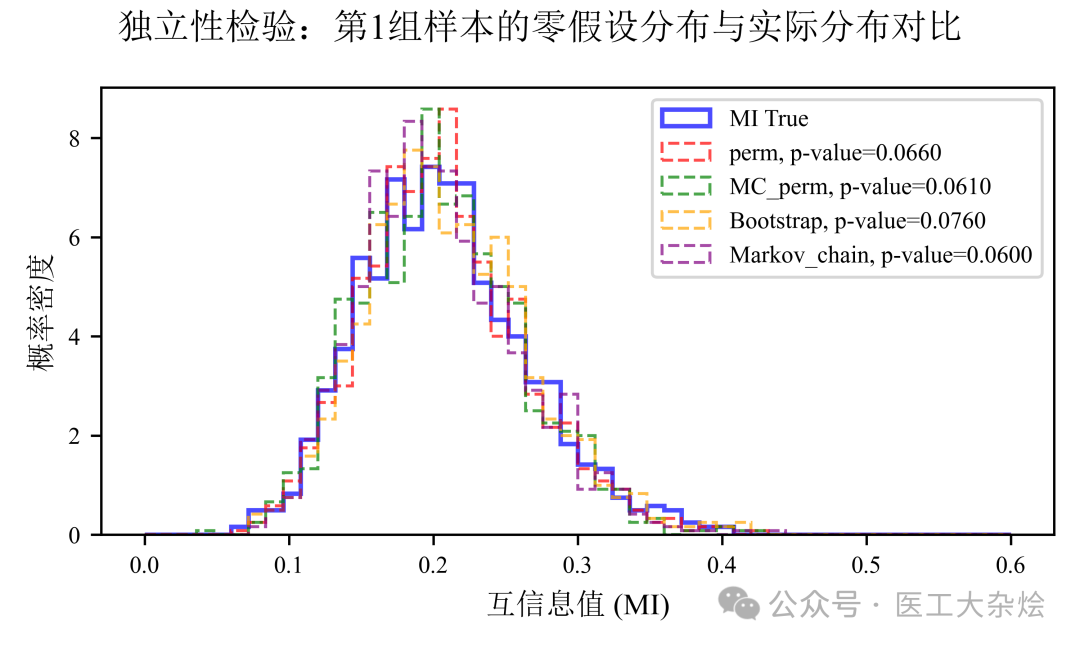
<p>下图展示了 $N_{\text{trials}}=1000$ 组独立投掷样本序列 $X$ 和 $Y$ 所得到的真实互信息分布，以及仅通过第1组100个样本在 $N_{\text{resample}}=1000$ 次重采样参数下通过置换检验（perm）、蒙特卡洛置换检验（MC_perm）、Bootstrap 检验（Bootstrap）和马尔可夫链检验（Markov_chain）获得的零假设互信息分布。</p>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%B0%8F%E6%A0%B7%E6%9C%AC%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E7%8B%AC%E7%AB%8B%E6%80%A7%E6%A3%80%E9%AA%8C/%E5%9B%BE4_%E7%8B%AC%E7%AB%8B%E6%8A%95%E6%8E%B7_%E9%9B%B6%E5%81%87%E8%AE%BE%E5%88%86%E5%B8%83%E5%AF%B9%E6%AF%94.png" width="700" />
</div>

<p>可以看出，所有检验方法得到的零假设分布均与真实分布高度一致，说明这四种方法均能有效地检验非马尔可夫数据的独立性。</p>

<h3 id="32-一阶投掷样本序列">3.2 一阶投掷样本序列</h3>

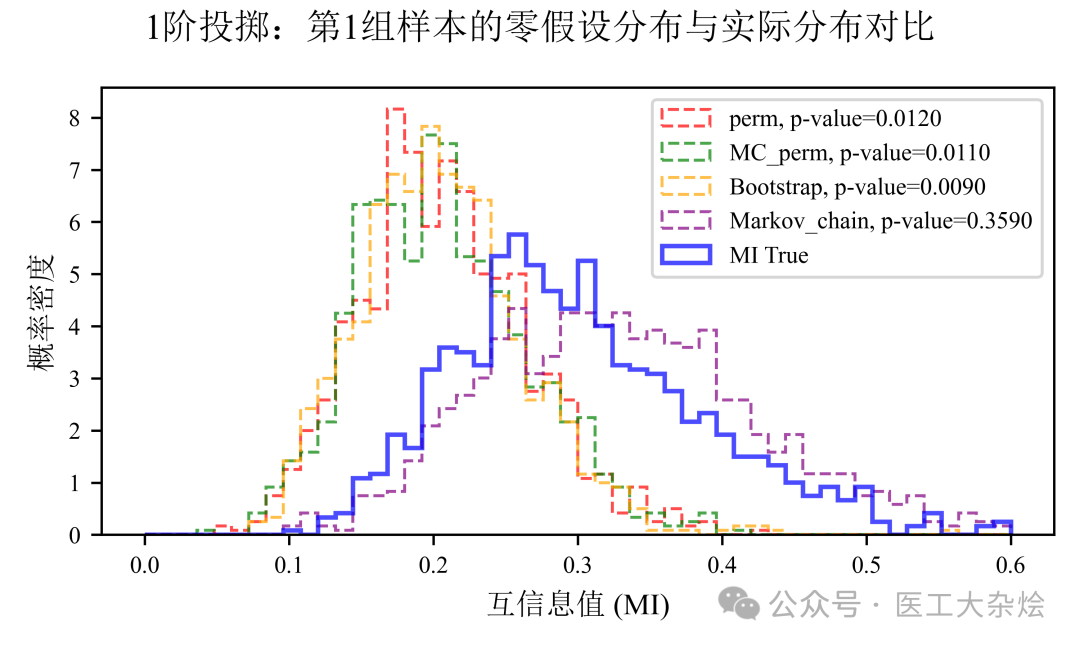
<p>下图继续展示了四种方法在1阶投掷样本序列 $X$ 和 $Y$ 上的零假设互信息分布与真实分布对比。</p>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-25-%E5%B0%8F%E6%A0%B7%E6%9C%AC%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E7%8B%AC%E7%AB%8B%E6%80%A7%E6%A3%80%E9%AA%8C/%E5%9B%BE5_1%E9%98%B6%E6%8A%95%E6%8E%B7_%E9%9B%B6%E5%81%87%E8%AE%BE%E5%88%86%E5%B8%83%E5%AF%B9%E6%AF%94.png" width="700" />
</div>

<p>这次情况发生了变化，置换检验、蒙特卡洛置换检验和 Bootstrap 检验的零假设分布与真实分布存在明显负向偏差，说明这三种方法在1阶马尔可夫链数据上失效，且更容易拒绝掉实际无关的MI值，接受 $H_1$ 备择假设，导致更高的<span style="background-color: #fff8b0">I类错误率</span>。相比之下，只有马尔可夫链检验所得的零假设分布与真实分布高度一致，说明其能够有效地检验1阶马尔可夫数据的独立性。</p>

<p>综上，只有马尔可夫链检验能够同时胜任非马尔可夫链和马尔可夫链数据的独立性检验，而其他三种方法在马尔可夫链数据上会出现较高的I类错误率。在算法实现时，可将非马尔可夫链数据的阶数设为0代入计算，提升通用性。</p>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[本文主要包括以下内容： 案例构建和样本采集 小样本量下的独立性检验]]></summary></entry><entry><title type="html">工业过程数据稳态判断</title><link href="https://ulti-dreisteine.github.io/academicpages/%E5%B7%A5%E4%B8%9A%E8%BF%87%E7%A8%8B%E6%95%B0%E6%8D%AE%E7%A8%B3%E6%80%81%E5%88%A4%E6%96%AD/" rel="alternate" type="text/html" title="工业过程数据稳态判断" /><published>2026-05-25T00:00:00+00:00</published><updated>2026-05-25T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/%E5%B7%A5%E4%B8%9A%E8%BF%87%E7%A8%8B%E6%95%B0%E6%8D%AE%E7%A8%B3%E6%80%81%E5%88%A4%E6%96%AD</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/%E5%B7%A5%E4%B8%9A%E8%BF%87%E7%A8%8B%E6%95%B0%E6%8D%AE%E7%A8%B3%E6%80%81%E5%88%A4%E6%96%AD/"><![CDATA[<p>如化工过程等连续的工业过程往往需要处于稳态运行以满足安全性和产品质量等要求，但是由于过程上游输入的不确定性，以及内部设备和操作参数的变化，稳态并不唯一。过程在不同稳态之间的切换形成了暂态。如DCS等所记录的时序数据中往往同时包含了稳态和暂态数据，对其中稳态数据的识别有助于过程建模和优化等工作。</p>

<hr />

<h2 id="一算法原理">一、算法原理</h2>

<h3 id="11-连续和离散小波变换">1.1 连续和离散小波变换</h3>

<p>不同的小波 $\Psi$ 具有不同形状，每类小波 $\it\Psi$ 的基波表达式为：</p>

\[\it\Psi_{s,\tau}(t) = \frac{1}{\sqrt{s}}\it\Psi\left(\frac{t - \tau}{s}\right) \tag{1}\]

<p>其中，参数 $s$ 为尺度参数（scale），其值越大，对应小波尺度越大，频率越低；$\tau$ 为时间位移参数（translation），用于控制小波在时间方向的移动。</p>

<p>在 <strong>连续小波变换（continuous wavelet transform, CWT）</strong> 中，$s$ 和 $\tau$ 连续取值，计算量较大且不同频率结果之间存在<strong>冗余</strong>（对于信号重构而言），而在 <strong>离散小波变换（discrete wavelet transform, DWT）</strong> 中，$s$ 和 $\tau$ 的取值则是离散的：</p>

\[\it\Psi_{j, k}(t) = \frac{1}{\sqrt{s_0^j}}\it\Psi\left(\frac{t - k\tau_0 s_0^j}{s_0^j} \right) \tag{2}\]

<p>其中，$j, k \in Z$，通常取 $\tau_0 = 1$，$s_0 = 2$。</p>

<blockquote>
  <p>注意，对于离散小波变换 DWT：</p>
  <ul>
    <li>尺度参数表征的是频率，<strong>在子小波中尺度参数以2的倍数增长（即小波的“长度”被“拉长”了2倍）</strong>，那么子小波对应能检测到的频率值也会以1/2的倍数缩小。母小波所对应的频谱位于频率谱的高端，具有最大的频率谱范围，而其他的子小波的频率谱则依次向频谱图的低频端移动，同时它们所覆盖的频率谱范围也相应地递减；</li>
    <li>在理想情况下，所有的滤波器应首尾相接互相覆盖。比如在第一级分解中，尺度参数 $s_0$ 值较小，因此滤波细节信号 $D_1$ 保留了大量高频信息（高通滤波），剩余的近似信号 $A_1$ 则进入下一步采用更大尺度参数 $2\times s_0$ 的分解，依此类推。因此，小波分解所得近似信号的频率逐级递减。</li>
  </ul>
</blockquote>

<h3 id="12-单变量稳态数据识别">1.2 单变量稳态数据识别</h3>

<p>设待识别变量为 $X_{\rm r}$，其时序数据为 $X_{\rm r} = {x_{\rm r, 1}, \cdots, x_{\rm r, N}}$，其中 $x_{\rm r, t}$ 为第 $t$ 个时刻的数据。对 $X_{\rm r}$ 进行<strong>离散小波变换 DWT</strong>，得到 $X_{\rm r}$ 的 $J$ 级小波分解系数 $W_{\rm r} = {W_{\rm r, j, k}}$，其中 $j = 1, 2, \cdots, J$ 为分解级数，$k = 1, 2, \cdots, N$ 为分解系数的时间索引。保留 $W_{\rm r}$ 中的低频分量，将其余分量置零，然后对 $W_{\rm r}$ 进行逆小波变换，得到新的时序数据 $X$。</p>

<p>接下来，从滤波后的 $X = {x_1, x_2, \cdots, x_N}$ 中提取稳态数据。设在时刻 $t$ 的记录 $x_t = f(t)$，则此时 $X$ 变化的一阶和二阶导数分别为 $f’(t)$ 和 $f’‘(t)$，如果两个导数变化绝对值均低于设定阈值，则可认为此时 $X$ 处于稳态。计算过程如下：</p>

<ol>
  <li>
    <p>确定稳态判断阈值参数 $T_s$、$T_w$ 和 $T_u$。其中，$T_s$ 和 $T_w$ 分别为过程稳态数据的一阶和二阶导数绝对值的90%或95%分位数。$T_u = \alpha \cdot T_s$，其中 $\alpha$ 为超参数，为 (2, 5) 之间可调的整数参数。</p>
  </li>
  <li>对于每个时刻 $t$：
    <ul>
      <li>
        <p>首先，计算系数 $\gamma(t)$：</p>

\[\gamma(t) = \left\{
       \begin{align*}
           &amp;0, \text{if } |f''(t)|\leq T_w \\
           &amp;\frac{f(t)-T_w}{2 T_w}, \text{if } T_w &lt; |f''(t)|\leq 3T_w\\
           &amp;1, \text{else}
       \end{align*}
       \right.\]
      </li>
      <li>
        <p>接下来，计算系数 $\theta(t)$：</p>

\[\theta(t) = (1 + \gamma(t)) |f''(t)|\]
      </li>
      <li>
        <p>然后，计算变量的瞬时稳态系数 $\beta(t)$：</p>

\[\beta(t) = \left\{
      \begin{align*}
          &amp;0, \text{if } \theta(t) &gt; T_u \\
          &amp;0.5\left(\cos\left(\frac{\theta(t) - T_s}{T_u - T_s}\right) + 1\right), \text{if } T_s &lt; \theta(t) &lt; T_u \\
          &amp;1, \text{else}
      \end{align*}
      \right.\]

        <p>稳态系数 $\beta(t)$ 的取值范围为 <code class="language-plaintext highlighter-rouge">[0, 1]</code>。当 $\beta(t) = 0$ 时，表示时刻 $t$ 处于非稳态，$\beta(t)$ 的取值越接近1，表示过程在时刻 $t$ 越平稳。</p>
      </li>
      <li>
        <p>最后，使用稳态系数阈值 $T_{\beta} = 1 - \varepsilon$ 对当前时刻的稳态系数 $\beta(t)$ 进行判断，其中 $\varepsilon \leq 0.1$ 为超参数。若 $\beta(t) \geq T_{\beta}$，则认为时刻 $t$ 处于稳态，否则处于非稳态。</p>
      </li>
    </ul>
  </li>
  <li>当对所有时刻 $t$ 都进行了稳态判断后，便获得了稳态和非稳态数据的时刻记录 $T_{ss}$ 和 $T_{ns}$。如果要求稳态数据长度不小于某一阈值 $L$，则进一步地从 $T_{ss}$ 中提取出所有满足单段连续长度不小于 $L$ 的稳态数据段，最后形成稳态时刻片段集合 $T_{ss}^{\rm seg}$，并提取对应的稳态数据片段集合 $\left{X_{ss}^{\rm seg}\right}$。</li>
</ol>

<h3 id="13-多变量稳态数据识别">1.3 多变量稳态数据识别</h3>

<p>在含有 $P$ 个变量的过程中，若每个变量均达到稳态，则过程整体达到稳态。因此，可通过如下的加权方式获得过程整体的瞬时稳态系数：</p>

\[B(t) = \prod_{i=1}^{P} \beta_i(t)^{w_i / \sum_{i=1}^P w_i} \tag{3}\]

<p>其中，$w_i$ 为每个变量的权重，可由用户指定。若 $B(t) \geq T_{\beta}$，则认为整个过程在时刻 $t$ 处于稳态。同样地，可按照上述2.2节中第3步求解满足最低稳态样本量要求 $L$ 的稳态样本片段集合。</p>

<hr />

<h2 id="二算例实现">二、算例实现</h2>

<h3 id="21-单变量稳态数据识别">2.1 单变量稳态数据识别</h3>

<p>从样本中，变量 $x_1$ 的原始数据记录如下：</p>

<p><img src="https://files.mdnice.com/user/67359/6521898b-4ee6-4fec-8115-d08ff46988b1.png =500x" alt="" /></p>

<p>其中红色标记区域为人工挑选的用于计算参数 $T_s$、$T_w$ 的稳态数据片段，长度为500。对该片段采用db4小波进行变换，得到滤波结果如下：</p>

<p><img src="https://files.mdnice.com/user/67359/9a7d5df9-f321-498e-a58c-cae213a576b1.png =500x" alt="" /></p>

<p>可见，滤波后结果更为平滑。最终求得参数值：$T_s = 0.28$、$T_w = 0.21$、$T_u = 0.56$。</p>

<p>接下来，对整个 $x_1$ 信号进行稳态识别，得到结果如下：</p>

<p><img src="https://files.mdnice.com/user/67359/6061e855-238c-4720-aa00-cc93f36a5082.png =450x" alt="" /></p>

<h3 id="22-多变量稳态数据识别">2.2 多变量稳态数据识别</h3>

<p>在2.1节的基础上，对同时含有多个变量过程的稳态进行识别。过程变量 $X_1$、$X_2$ 和 $X_3$ 的原始数据记录如下：</p>

<p><img src="https://files.mdnice.com/user/67359/dffa1623-07ce-4937-8de4-32b30478bc56.png =500x" alt="" /></p>

<p>其中，红色标记区域为人工挑选的用于计算参数 $T_s$、$T_w$ 的稳态数据片段，长度为500。计算获得各变量稳定系数和过程稳定系数变化如下：</p>

<p><img src="https://files.mdnice.com/user/67359/af18c0bf-ae38-4388-a4d5-d1941ec14028.png =500x" alt="" /></p>

<p>最终获得过程稳态识别结果如下：</p>

<p><img src="https://files.mdnice.com/user/67359/9076b58e-5462-4f7e-92ac-dd4ea33ec7b8.png =500x" alt="" /></p>

<hr />

<h2 id="三参考文献">三、参考文献</h2>

<ol>
  <li>T. Jiang, B. Chen, X. He, et al. Application of Steady-State Detection Method Based on Wavelet Transform, Computers &amp; Chemical Engineering, 2002.</li>
</ol>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[如化工过程等连续的工业过程往往需要处于稳态运行以满足安全性和产品质量等要求，但是由于过程上游输入的不确定性，以及内部设备和操作参数的变化，稳态并不唯一。过程在不同稳态之间的切换形成了暂态。如DCS等所记录的时序数据中往往同时包含了稳态和暂态数据，对其中稳态数据的识别有助于过程建模和优化等工作。]]></summary></entry><entry><title type="html">马尔可夫链定阶</title><link href="https://ulti-dreisteine.github.io/academicpages/%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E5%AE%9A%E9%98%B6/" rel="alternate" type="text/html" title="马尔可夫链定阶" /><published>2026-05-25T00:00:00+00:00</published><updated>2026-05-25T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E5%AE%9A%E9%98%B6</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/%E9%A9%AC%E5%B0%94%E5%8F%AF%E5%A4%AB%E9%93%BE%E5%AE%9A%E9%98%B6/"><![CDATA[<p>马尔可夫链定阶目的在于通过<strong>统计检验</strong>确定一个时间序列是否可以用一个有限阶的马尔可夫链来描述，为其他相关研究（比如独立性检验）奠定基础。</p>

<hr />

<h2 id="一定阶检验原理">一、定阶检验原理</h2>

<h3 id="11-基于块熵的定阶检验">1.1 基于块熵的定阶检验</h3>

<p>块熵是信息论中用于衡量序列不确定性的指标，描述长度为 $L$ 的连续序列块的熵值，反映了系统在特定时间尺度下的复杂度，计算公式为：</p>

\[H(L) = - \sum_{x^L} P(x^L) \log P(x^L) \tag{1}\]

<p>如果序列完全随机，则 $H(L) = L\cdot H(1)$ 达到最大值；否则，$H(L) &lt; L\cdot H(1)$。如果在 $L\geq K$时，$H(L+1) - H(L)$ 趋于稳定，则可以认为序列的马尔可夫阶数为 $K$。</p>

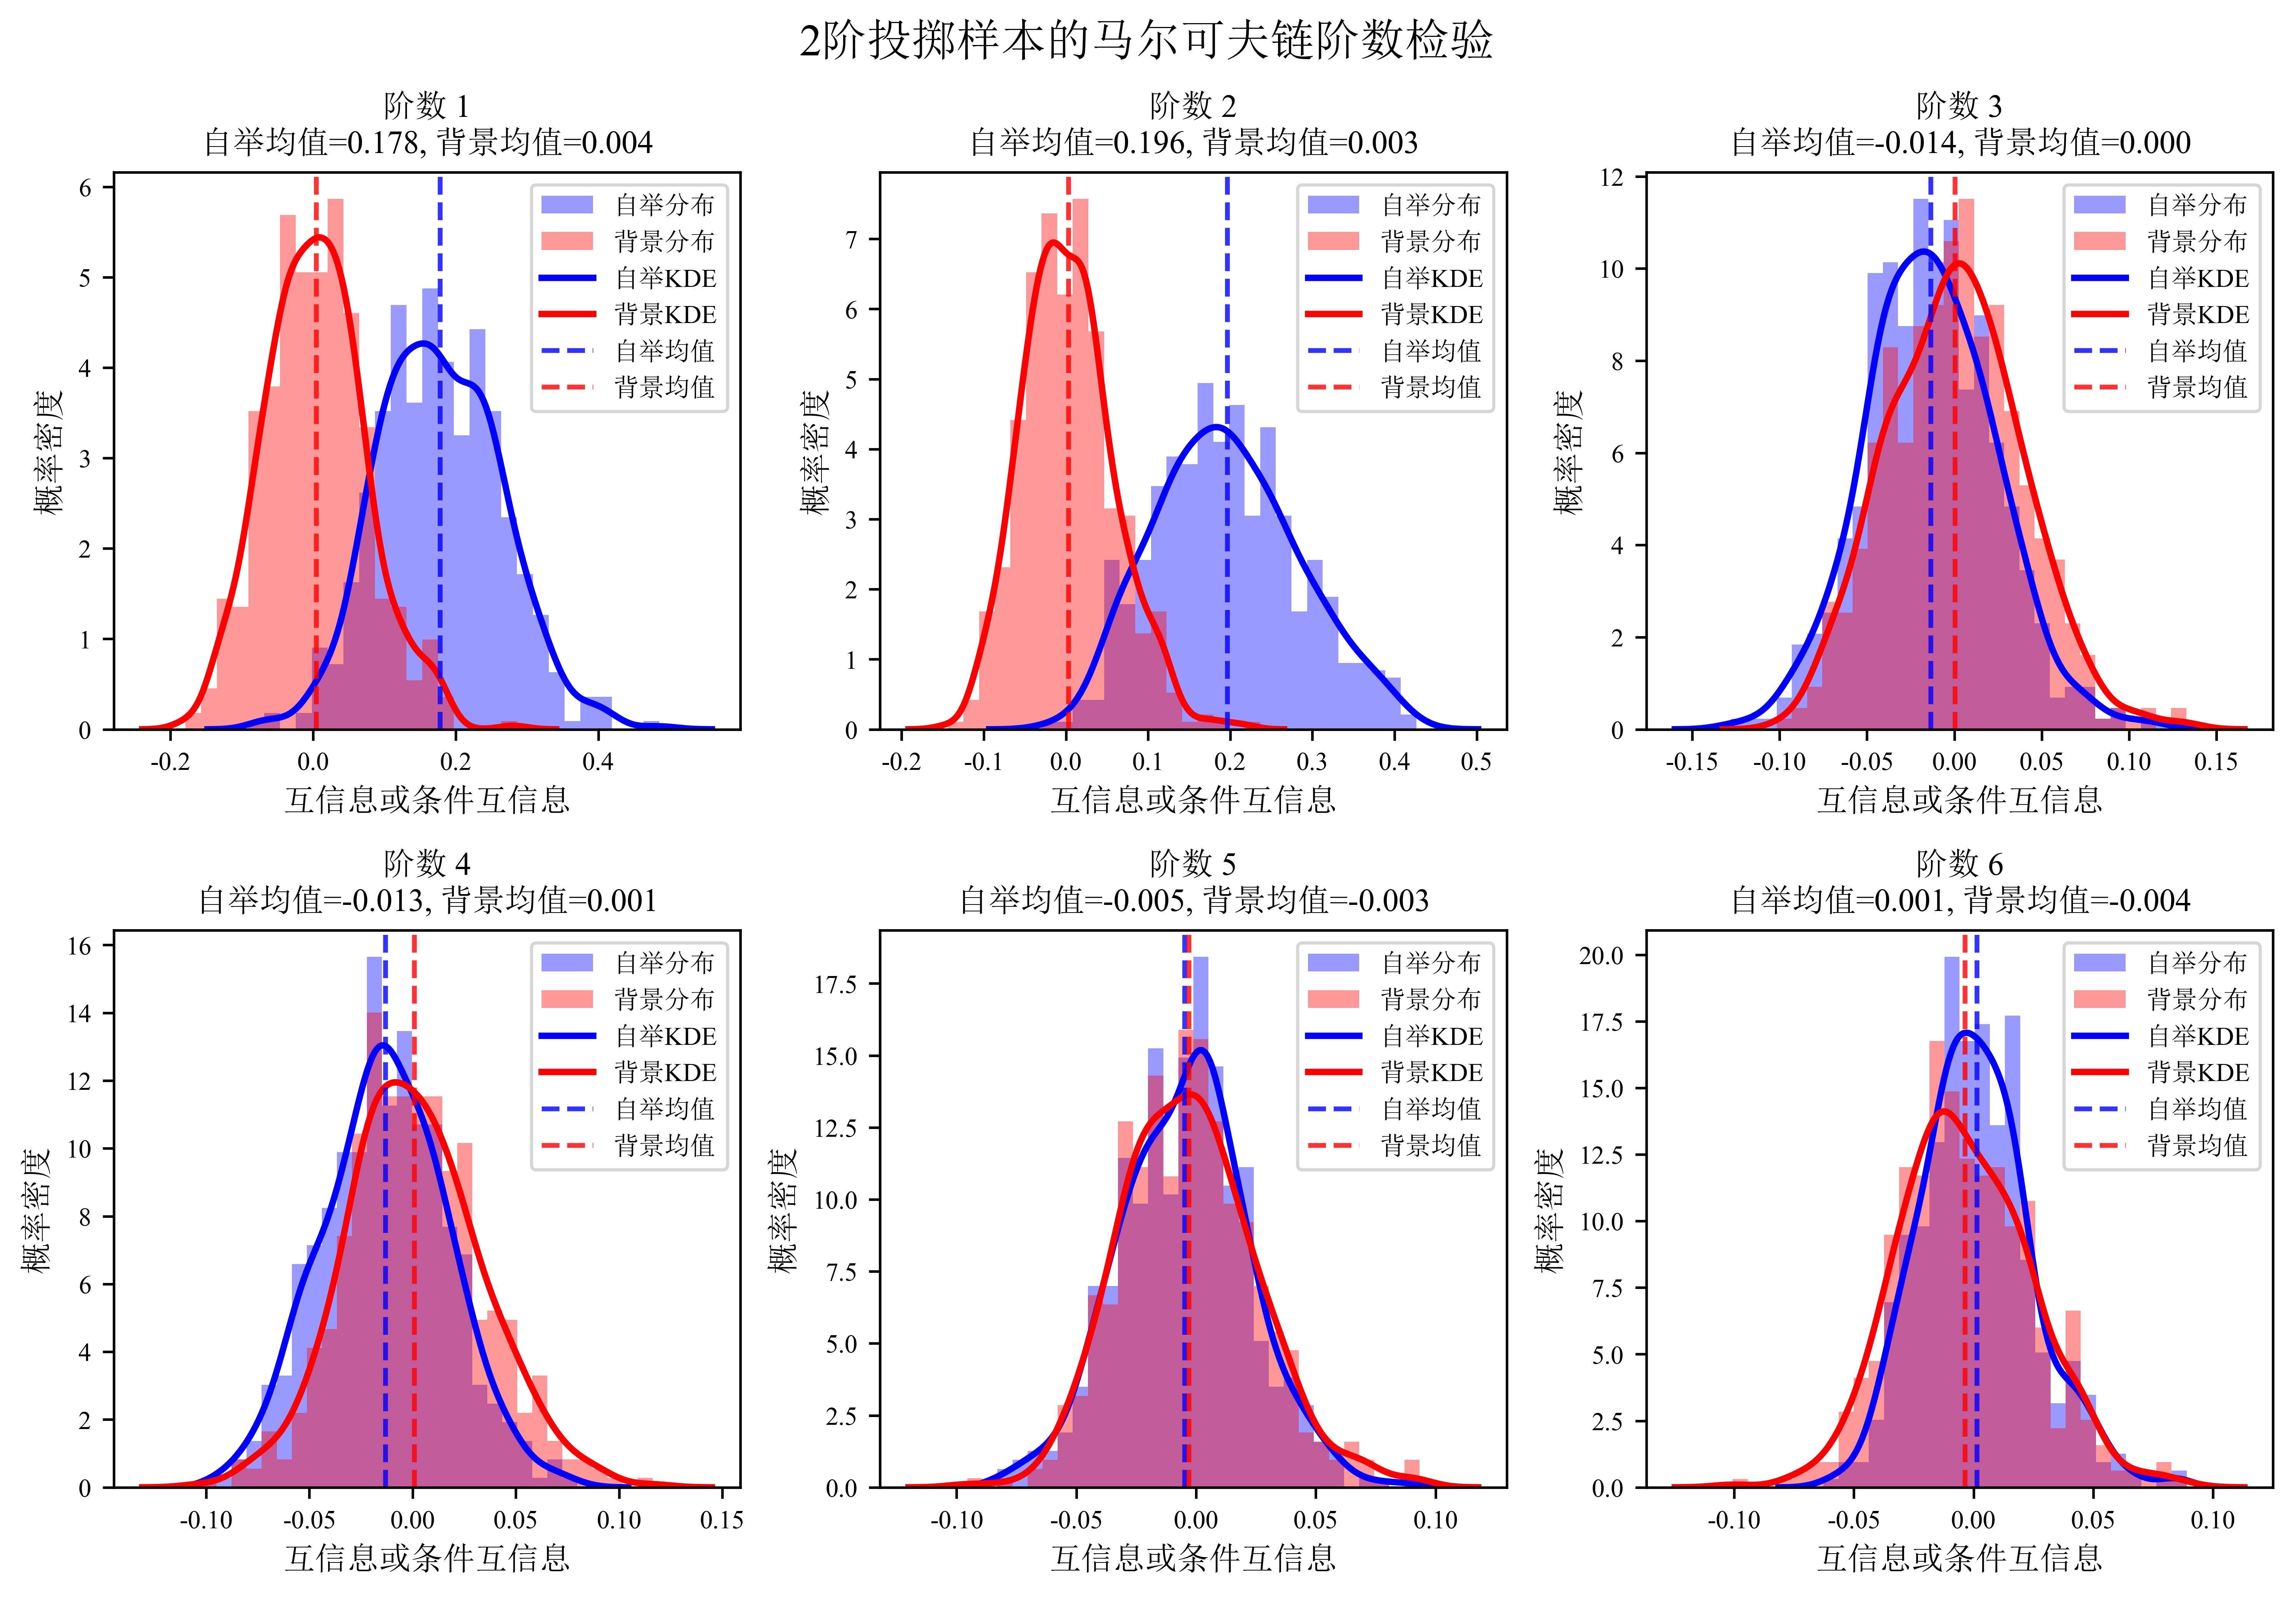
<p>Pethel等[1]提出了一种基于块熵和独立性检验的马尔可夫定阶方法，但我自己复现效果并不稳定，不能确定是算例的特殊性原因还是方法原因。</p>

<h3 id="12-基于互信息和条件互信息的定阶检验">1.2 基于互信息和条件互信息的定阶检验</h3>

<p>互信息（Mutual Information, MI）是衡量两个随机变量之间相互依赖关系的指标。对于离散和连续随机变量的定义分别为：</p>

\[I(X;Y) = \sum_{x,y} P(x,y) \log \frac{P(x,y)}{P(x)P(y)} \tag{2}\]

\[I(X;Y) = \int \int p(x,y) \log \frac{p(x,y)}{p(x)p(y)} dx dy \tag{3}\]

<p>条件互信息（Conditional Mutual Information, CMI）则衡量在给定第三个变量的条件下，两个变量之间的依赖关系。CMI可基于MI推导而得：</p>

\[I(X;Y|Z) = I(X;Y, Z) - I(X;Z) \tag{4}\]

<p>在阶数为 $K$ 的马尔可夫链中，处于时刻 $t$ 的状态 $X_t$ 仅与前 $K$ 个状态 $X_{t-1}, X_{t-2}, \ldots, X_{t-K}$ 直接相关，因此存在如下的条件独立性：</p>

<p>当 $1 \leq k &lt; K$ 时：</p>

\[I(X_t; X_{t-k-1} | X_{t-1}, \ldots, X_{t-k}) &gt; 0 \tag{5}\]

<p>当 $k \geq K$ 时：</p>

\[I(X_t; X_{t-k-1} | X_{t-1}, \ldots, X_{t-K}) = 0 \tag{6}\]

<p>特别地：</p>

\[I(X_t; X_{t-1}) &gt; 0 \tag{7}\]

<hr />

<h2 id="二定阶检验案例">二、定阶检验案例</h2>

<p>骰子 $X$ 有6个面，对其进行 $N_{\text{steps}}=1000$ 次投掷，投掷过程分别遵循如下状态转移矩阵 $\boldsymbol{\pi}$ 所确定的0至2阶马尔可夫过程：</p>

<p><strong>0阶投掷的状态转移矩阵：</strong></p>

\[\boldsymbol{\pi} = \frac{1}{6} \cdot \mathbf{1}_{6 \times 6}\]

<p><strong>1阶投掷的状态转移矩阵：</strong></p>

\[\boldsymbol{\pi} = \begin{bmatrix}
0.5   &amp; 0.25 &amp; 0    &amp; 0    &amp; 0    &amp; 0.25 \\
0.25  &amp; 0.5  &amp; 0.25 &amp; 0    &amp; 0    &amp; 0    \\
0     &amp; 0.25 &amp; 0.5  &amp; 0.25 &amp; 0    &amp; 0    \\
0     &amp; 0    &amp; 0.25 &amp; 0.5  &amp; 0.25 &amp; 0    \\
0     &amp; 0    &amp; 0    &amp; 0.25 &amp; 0.5  &amp; 0.25 \\
0.25  &amp; 0    &amp; 0    &amp; 0    &amp; 0.25 &amp; 0.5
\end{bmatrix}\]

<p><strong>2阶投掷的状态转移矩阵：</strong></p>

<p>对于任意历史状态 $(s_{t-2}, s_{t-1}) \in \mathcal{S}^2$：</p>

\[\pi(X_t \mid X_{t-2}, X_{t-1}) = \begin{cases}
[0.7, 0.2, 0.1] &amp; \text{if } (0,0) \\
[0.1, 0.6, 0.3] &amp; \text{if } (0,1) \\
[0.2, 0.2, 0.6] &amp; \text{if } (0,2) \\
[0.3, 0.4, 0.3] &amp; \text{if } (1,0) \\
[0.1, 0.8, 0.1] &amp; \text{if } (1,1) \\
[0.0, 0.1, 0.9] &amp; \text{if } (1,2) \\
[0.5, 0.5, 0.0] &amp; \text{if } (2,0) \\
[0.2, 0.3, 0.5] &amp; \text{if } (2,1) \\
[0.1, 0.1, 0.8] &amp; \text{if } (2,2)
\end{cases}\]

<p>检验结果如下：</p>

<p><strong>0阶投掷的检验结果：</strong></p>

<p><img src="https://files.mdnice.com/user/67359/52a0a4ce-2b0c-4e26-87eb-2dc355ce4c0e.jpg" alt="" /></p>

<p><strong>1阶投掷的检验结果：</strong></p>

<p><img src="https://files.mdnice.com/user/67359/eb050877-f956-4c90-8a10-a29171c668f9.jpg" alt="" /></p>

<p><strong>2阶投掷的检验结果：</strong></p>

<p><img src="https://files.mdnice.com/user/67359/dbc338c6-6d99-43d8-b48f-ce6fd77e99c9.jpg" alt="" /></p>

<p>可见，基于MI和CMI的定阶检验方法能够有效地识别出马尔可夫链的阶数，<span style="background-color: #fff3cd; padding: 2px 4px; border-radius: 2px;">在对应阶数处的信息量分布与背景分布呈现显著差异。</span></p>

<p>此过程还涉及Markov链自举重采样和多维变量概率密度估计等细节问题，此处按下不表。</p>

<h2 id="参考文献">参考文献</h2>

<p>[1] S.D. Pethel, D.W. Hahs: Exact Test of Independence Using Mutual Information, 2014.</p>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[马尔可夫链定阶目的在于通过统计检验确定一个时间序列是否可以用一个有限阶的马尔可夫链来描述，为其他相关研究（比如独立性检验）奠定基础。]]></summary></entry><entry><title type="html">广义加性模型原理</title><link href="https://ulti-dreisteine.github.io/academicpages/%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E5%8E%9F%E7%90%86/" rel="alternate" type="text/html" title="广义加性模型原理" /><published>2026-05-11T00:00:00+00:00</published><updated>2026-05-11T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E5%8E%9F%E7%90%86</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E5%8E%9F%E7%90%86/"><![CDATA[<p>广义加性模型（Generalized Additive Model，GAM）用于描述响应变量与多个预测变量之间的非线性关系，同时保留较好的可解释性。</p>

<h2 id="一基本介绍"><strong>一、基本介绍</strong></h2>

<p>设样本集为</p>

\[\{(x_{k,1},x_{k,2},\cdots,x_{k,p},y_k)\mid 1\le k\le N\},\]

<p>其中，$k$ 为样本索引，$N$ 为样本量，$p$ 为特征维数。GAM 的一般形式为</p>

\[g(\mu_k)=\beta_0+\sum_{i=1}^{p} f_i(x_{k,i}), \qquad \mu_k=\mathbb{E}(y_k\mid x_{k,1},\cdots,x_{k,p}),\]

<p>其中：</p>

<ul>
  <li>$g(\cdot)$ 是链接函数；</li>
  <li>$\mu_k$ 是条件均值；</li>
  <li>$\beta_0$ 是截距项；</li>
  <li>$f_i(\cdot)$ 是第 $i$ 个特征对应的平滑函数。</li>
</ul>

<p>当响应变量服从高斯分布且取恒等链接 $g(\mu)=\mu$ 时，上式退化为更熟悉的加性回归形式：</p>

\[y_k=\beta_0+\sum_{i=1}^{p} f_i(x_{k,i})+\varepsilon_k,\]

<p>其中通常假设 $\varepsilon_k \overset{\text{i.i.d.}}{\sim} \mathcal{N}(0,\sigma^2)$。</p>

<p>需要注意的是，GAM 中截距项与各个平滑函数之间存在可辨识性问题。为使分解唯一，通常需要施加约束，例如</p>

\[\sum_{k=1}^{N} f_i(x_{k,i})=0, \qquad i=1,2,\cdots,p.\]

<p>这样可以避免平滑函数中的常数部分与截距项 $\beta_0$ 混淆。</p>

<hr />
<h2 id="二单特征拟合"><strong>二、单特征拟合</strong></h2>

<p>以下为便于说明，先考虑单特征情形，并假设响应变量为高斯型且采用恒等链接。此时模型写为</p>

\[y_k=\beta_0+f(x_k)+\varepsilon_k.\]

<p>这里将唯一的平滑函数记为 $f(\cdot)$。常见的平滑表示方式包括：</p>

<ul>
  <li>多项式回归：$f(x)=\beta_1 x+\beta_2 x^2+\cdots+\beta_d x^d$；</li>
  <li>回归样条：$f(x)=\sum_{j=1}^{m} \beta_j B_j(x)$；</li>
  <li>平滑样条：在样条表示基础上加入平滑惩罚；</li>
  <li>核回归：通过核函数对邻近样本加权；</li>
  <li>局部加权回归：在局部邻域内做加权拟合。</li>
</ul>

<p>其中，样条基函数展开是最常用的形式之一。</p>

<h3 id="21-基函数展开"><strong>2.1 基函数展开</strong></h3>

<p>设选择了 $m$ 个基函数 $B_1(x),\cdots,B_m(x)$，则可将平滑函数写为</p>

\[f(x)=\sum_{j=1}^{m} \beta_j B_j(x).\]

<p>因此，对任意一个样本点 $x_k$，都有</p>

\[f(x_k)=\sum_{j=1}^{m} \beta_j B_j(x_k),\]

<p>从而模型可表示为</p>

\[y_k=\beta_0+\sum_{j=1}^{m} \beta_j B_j(x_k)+\varepsilon_k.\]

<p>这里需要强调：上式只是对函数 $f(x)$ 的<strong>表示方式</strong>，并不意味着仅凭单个样本点 $(x_k,y_k)$ 就能估计全部参数。参数估计必须依赖多个样本点共同完成。</p>

<p>在实际应用中，常选用 B 样条作为基函数，因为它兼具局部支撑性、数值稳定性和较强的拟合能力。通过调整基函数个数 $m$ 及节点位置，可以控制模型复杂度与拟合效果 <a href="https://pages.mtu.edu/~shene/COURSES/cs3621/NOTES/spline/B-spline/bspline-basis.html">1</a>。</p>

<h3 id="22-单特征多点拟合"><strong>2.2 单特征多点拟合</strong></h3>

<p>给定 $N$ 个样本点 $(x_k,y_k)$，将上式对所有样本同时写出，可得矩阵形式</p>

\[\mathbf{y}=\mathbf{B}\boldsymbol{\beta}+\boldsymbol{\varepsilon},\]

<p>其中</p>

\[\mathbf{y}=\begin{pmatrix}y_1\\y_2\\\vdots\\y_N\end{pmatrix},
\quad
\mathbf{B}=\begin{pmatrix}
1 &amp; B_1(x_1) &amp; B_2(x_1) &amp; \cdots &amp; B_m(x_1) \\
1 &amp; B_1(x_2) &amp; B_2(x_2) &amp; \cdots &amp; B_m(x_2) \\
\vdots &amp; \vdots &amp; \vdots &amp; \ddots &amp; \vdots \\
1 &amp; B_1(x_N) &amp; B_2(x_N) &amp; \cdots &amp; B_m(x_N)
\end{pmatrix},\]

\[\boldsymbol{\beta}=\begin{pmatrix}\beta_0\\\beta_1\\\beta_2\\\vdots\\\beta_m\end{pmatrix},
\quad
\boldsymbol{\varepsilon}=\begin{pmatrix}\varepsilon_1\\\varepsilon_2\\\vdots\\\varepsilon_N\end{pmatrix}.\]

<p>其中，设计矩阵 $\mathbf{B}\in\mathbb{R}^{N\times(m+1)}$ 的第一列对应截距项，其余各列对应基函数在样本点处的取值。</p>

<p>若暂不考虑平滑惩罚，则可通过最小二乘法求解</p>

\[\begin{aligned}
\min_{\boldsymbol{\beta}}\ \|\mathbf{y}-\mathbf{B}\boldsymbol{\beta}\|_2^2
&amp;=\min_{\beta_0,\beta_1,\cdots,\beta_m}
\sum_{k=1}^{N}\left(y_k-\beta_0-\sum_{j=1}^{m}\beta_j B_j(x_k)\right)^2.
\end{aligned}\]

<p>当 $\mathbf{B}^\top \mathbf{B}$ 可逆时，最小二乘解为</p>

\[\hat{\boldsymbol{\beta}}=(\mathbf{B}^\top \mathbf{B})^{-1}\mathbf{B}^\top \mathbf{y}.\]

<p>若 $\mathbf{B}^\top \mathbf{B}$ 不可逆，则通常需要使用广义逆或引入正则化。</p>

<h3 id="23-惩罚回归"><strong>2.3 惩罚回归</strong></h3>

<p>当基函数个数 $m$ 较大时，仅最小化残差平方和虽然能提高训练集拟合程度，但也更容易导致过拟合，即拟合曲线过于波动、泛化能力下降。</p>

<p>为控制平滑函数的复杂度，通常在损失函数中加入惩罚项，得到</p>

\[\min_{\beta_0,\beta_1,\cdots,\beta_m}
\sum_{k=1}^{N}\left(y_k-\beta_0-\sum_{j=1}^{m}\beta_j B_j(x_k)\right)^2
+
\lambda J(f),\]

<p>其中：</p>

<ul>
  <li>第一项为残差平方和，用于衡量拟合误差；</li>
  <li>第二项 $\lambda J(f)$ 为惩罚项，用于控制函数复杂度；</li>
  <li>$\lambda\ge 0$ 为平滑参数，用于平衡拟合精度与平滑程度。</li>
</ul>

<p>常见的惩罚形式是函数曲率的平方积分：</p>

\[J(f)=\int \bigl(f''(x)\bigr)^2\,dx.\]

<p>其含义是：若函数二阶导数较大，说明曲线弯曲更剧烈，则惩罚更强；若函数更平滑，则惩罚更小。</p>

<p>平滑参数 $\lambda$ 的作用可概括为：</p>

<ul>
  <li>当 $\lambda=0$ 时，模型退化为普通最小二乘拟合；</li>
  <li>当 $\lambda$ 较小时，模型更强调贴合数据；</li>
  <li>当 $\lambda$ 较大时，模型更强调函数平滑；</li>
  <li>当 $\lambda\to\infty$ 时，函数会被强烈约束到更简单的形式。</li>
</ul>

<p>在矩阵形式下，惩罚回归通常写为</p>

\[\min_{\boldsymbol{\beta}}\ \|\mathbf{y}-\mathbf{B}\boldsymbol{\beta}\|_2^2
+
\lambda\,\boldsymbol{\beta}^\top \mathbf{\Omega}\boldsymbol{\beta},\]

<p>其中 $\mathbf{\Omega}$ 是由基函数及其导数构造出的惩罚矩阵。若不对截距项施加惩罚，则通常令 $\mathbf{\Omega}$ 的第一行和第一列为零。</p>

<p>当矩阵 $\mathbf{B}^\top\mathbf{B}+\lambda\mathbf{\Omega}$ 可逆时，解可写为</p>

\[\hat{\boldsymbol{\beta}}=
\left(\mathbf{B}^\top\mathbf{B}+\lambda\mathbf{\Omega}\right)^{-1}\mathbf{B}^\top\mathbf{y}.\]

<p>因此，GAM 的核心思想之一就是：通过“基函数展开 + 平滑惩罚”的方式，在保留非线性拟合能力的同时抑制过拟合。</p>

<hr />
<h2 id="三多特征拟合"><strong>三、多特征拟合</strong></h2>

<p>在多特征情形下，GAM 假设每个特征都对应一个平滑函数。在高斯响应、恒等链接的设定下，模型写为</p>

\[y_k=\beta_0+\sum_{i=1}^{p} f_i(x_{k,i})+\varepsilon_k.\]

<p>例如，当 $p=2$ 时，有</p>

\[y_k=\beta_0+f_1(x_{k,1})+f_2(x_{k,2})+\varepsilon_k.\]

<p>这种结构能够分别刻画各个特征对响应变量的非线性影响，同时保持较强的可解释性。</p>

<p>若对每个特征 $x_{k,i}$ 都选取 $m_i$ 个基函数 $B_{i,1}(\cdot),\cdots,B_{i,m_i}(\cdot)$，则第 $i$ 个平滑函数可表示为</p>

\[f_i(x)=\sum_{j=1}^{m_i} \beta_{i,j} B_{i,j}(x).\]

<p>于是整体模型可写为</p>

\[y_k=\beta_0+\sum_{i=1}^{p}\sum_{j=1}^{m_i}\beta_{i,j}B_{i,j}(x_{k,i})+\varepsilon_k.\]

<p>将所有样本写成矩阵形式，仍可记为</p>

\[\mathbf{y}=\mathbf{B}\boldsymbol{\beta}+\boldsymbol{\varepsilon},\]

<p>其中设计矩阵 $\mathbf{B}$ 的每一行对应一个样本，包含截距项以及所有特征对应的基函数取值，即</p>

\[\mathbf{B}=
\begin{bmatrix}
1 &amp; B_{1,1}(x_{1,1}) &amp; \cdots &amp; B_{1,m_1}(x_{1,1}) &amp; B_{2,1}(x_{1,2}) &amp; \cdots &amp; B_{2,m_2}(x_{1,2}) &amp; \cdots &amp; B_{p,1}(x_{1,p}) &amp; \cdots &amp; B_{p,m_p}(x_{1,p}) \\
1 &amp; B_{1,1}(x_{2,1}) &amp; \cdots &amp; B_{1,m_1}(x_{2,1}) &amp; B_{2,1}(x_{2,2}) &amp; \cdots &amp; B_{2,m_2}(x_{2,2}) &amp; \cdots &amp; B_{p,1}(x_{2,p}) &amp; \cdots &amp; B_{p,m_p}(x_{2,p}) \\
\vdots &amp; \vdots &amp; \ddots &amp; \vdots &amp; \vdots &amp; \ddots &amp; \vdots &amp; \cdots &amp; \vdots &amp; \ddots &amp; \vdots \\
1 &amp; B_{1,1}(x_{N,1}) &amp; \cdots &amp; B_{1,m_1}(x_{N,1}) &amp; B_{2,1}(x_{N,2}) &amp; \cdots &amp; B_{2,m_2}(x_{N,2}) &amp; \cdots &amp; B_{p,1}(x_{N,p}) &amp; \cdots &amp; B_{p,m_p}(x_{N,p})
\end{bmatrix}.\]

<p>相应地，参数向量为</p>

\[\boldsymbol{\beta}=
\begin{bmatrix}
\beta_0 \\
\beta_{1,1} \\
\vdots \\
\beta_{1,m_1} \\
\beta_{2,1} \\
\vdots \\
\beta_{2,m_2} \\
\vdots \\
\beta_{p,1} \\
\vdots \\
\beta_{p,m_p}
\end{bmatrix},
\qquad
\boldsymbol{\varepsilon}=
\begin{bmatrix}
\varepsilon_1 \\
\varepsilon_2 \\
\vdots \\
\varepsilon_N
\end{bmatrix}.\]

<p>若采用惩罚估计，则优化问题可写为</p>

\[\min_{\boldsymbol{\beta}}
\ \|\mathbf{y}-\mathbf{B}\boldsymbol{\beta}\|_2^2
+
\sum_{i=1}^{p} \lambda_i J(f_i),\]

<p>其中 $\lambda_i\ge 0$ 是第 $i$ 个平滑函数对应的平滑参数。若为简化起见，也可以取统一的平滑参数，即令 $\lambda_1=\cdots=\lambda_p=\lambda$。</p>

<p>常见的惩罚项形式为</p>

\[J(f_i)=\int \bigl(f_i''(x)\bigr)^2\,dx,
\qquad i=1,2,\cdots,p.\]

<p>于是总体惩罚可写为</p>

\[\sum_{i=1}^{p} \lambda_i J(f_i) = \sum_{i=1}^{p} \lambda_i \int \bigl(f_i''(x)\bigr)^2\,dx.\]

<p>在矩阵形式下，上式可进一步写为</p>

\[\min_{\boldsymbol{\beta}}\ \|\mathbf{y}-\mathbf{B}\boldsymbol{\beta}\|_2^2
+
\boldsymbol{\beta}^\top \mathbf{\Omega}\boldsymbol{\beta},\]

<p>其中 $\mathbf{\Omega}$ 通常为分块对角矩阵，其各个分块分别对应不同平滑函数的惩罚矩阵，截距项对应的分块取零。</p>

<p>综上，GAM 通过将高维非线性关系分解为若干个一维平滑函数之和，在模型灵活性与可解释性之间取得了较好的平衡。</p>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[广义加性模型（Generalized Additive Model，GAM）用于描述响应变量与多个预测变量之间的非线性关系，同时保留较好的可解释性。]]></summary></entry><entry><title type="html">广义加性模型算例</title><link href="https://ulti-dreisteine.github.io/academicpages/%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E7%AE%97%E4%BE%8B/" rel="alternate" type="text/html" title="广义加性模型算例" /><published>2026-05-11T00:00:00+00:00</published><updated>2026-05-11T00:00:00+00:00</updated><id>https://ulti-dreisteine.github.io/academicpages/%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E7%AE%97%E4%BE%8B</id><content type="html" xml:base="https://ulti-dreisteine.github.io/academicpages/%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E7%AE%97%E4%BE%8B/"><![CDATA[<p>本算例展示三项内容：</p>
<ol>
  <li>先用默认的 LinearGAM 作为同方差基线；</li>
  <li>再用 LinearGAM + FGLS 近似处理异方差；</li>
  <li>对比两种预测区间在噪声随 $x$ 增大时的差异。</li>
</ol>

<h2 id="一环境配置"><strong>一、环境配置</strong></h2>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>conda create <span class="nt">-n</span> pyGAM <span class="nv">python</span><span class="o">=</span>3.11
conda activate pyGAM

pip <span class="nb">install </span><span class="nv">pygam</span><span class="o">==</span>0.12.0
pip <span class="nb">install </span><span class="nv">seaborn</span><span class="o">==</span>0.13.2
pip <span class="nb">install </span><span class="nv">jupyter</span><span class="o">==</span>1.1.1
</code></pre></div></div>

<p>导入必要的库：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">matplotlib.ticker</span> <span class="kn">import</span> <span class="n">MultipleLocator</span><span class="p">,</span> <span class="n">AutoMinorLocator</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="nn">seaborn</span> <span class="k">as</span> <span class="n">sns</span>
<span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>

<span class="kn">from</span> <span class="nn">pygam</span> <span class="kn">import</span> <span class="n">LinearGAM</span>
</code></pre></div></div>

<hr />
<h2 id="二生成测试样本"><strong>二、生成测试样本</strong></h2>

<p>本算例展示三项内容：</p>
<ol>
  <li>先用默认的 LinearGAM 作为同方差基线；</li>
  <li>再用 LinearGAM + FGLS 近似处理异方差；</li>
  <li>对比两种预测区间在噪声随 $x$ 增大时的差异。</li>
</ol>

<p>生成测试样本：</p>
<ol>
  <li>均值函数设为 $3 + \log(x + 1)$；</li>
  <li>噪声标准差设为 $0.1(0.1x + 1)$，因此噪声会随 $x$ 增大而增大；</li>
  <li>固定随机种子，保证 notebook 每次运行结果一致。</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">rng</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">default_rng</span><span class="p">(</span><span class="mi">42</span><span class="p">)</span>
<span class="n">x_samples</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linspace</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">100</span><span class="p">,</span> <span class="mi">1000</span><span class="p">)</span>
<span class="n">X</span> <span class="o">=</span> <span class="n">x_samples</span><span class="p">.</span><span class="n">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>

<span class="n">y_true</span> <span class="o">=</span> <span class="mi">3</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="n">x_samples</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">noise_scale</span> <span class="o">=</span> <span class="mf">0.1</span> <span class="o">*</span> <span class="p">(</span><span class="mf">0.1</span> <span class="o">*</span> <span class="n">x_samples</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">y_samples</span> <span class="o">=</span> <span class="n">y_true</span> <span class="o">+</span> <span class="n">rng</span><span class="p">.</span><span class="n">normal</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">noise_scale</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="n">x_samples</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>
</code></pre></div></div>

<p>先定义统一的绘图辅助函数，并查看模拟样本。</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">configure_plot_style</span><span class="p">():</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">rcParams</span><span class="p">[</span><span class="s">"font.family"</span><span class="p">]</span> <span class="o">=</span> <span class="s">"Times New Roman"</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">rcParams</span><span class="p">[</span><span class="s">"mathtext.fontset"</span><span class="p">]</span> <span class="o">=</span> <span class="s">"stix"</span>


<span class="k">def</span> <span class="nf">apply_axis_style</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">x_values</span><span class="p">,</span> <span class="n">y_values</span><span class="p">,</span> <span class="n">title</span><span class="p">,</span> <span class="n">xlabel</span><span class="o">=</span><span class="s">"$x$"</span><span class="p">,</span> <span class="n">ylabel</span><span class="o">=</span><span class="s">"$y$"</span><span class="p">):</span>
    <span class="n">x_step</span> <span class="o">=</span> <span class="nb">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nb">int</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nb">max</span><span class="p">(</span><span class="n">x_values</span><span class="p">)</span> <span class="o">/</span> <span class="mi">20</span><span class="p">))</span>
    <span class="n">y_range</span> <span class="o">=</span> <span class="nb">max</span><span class="p">(</span><span class="nb">float</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nb">max</span><span class="p">(</span><span class="n">y_values</span><span class="p">)</span> <span class="o">-</span> <span class="n">np</span><span class="p">.</span><span class="nb">min</span><span class="p">(</span><span class="n">y_values</span><span class="p">)),</span> <span class="mf">1.0</span><span class="p">)</span>
    <span class="n">y_step</span> <span class="o">=</span> <span class="nb">max</span><span class="p">(</span><span class="mf">0.5</span><span class="p">,</span> <span class="nb">round</span><span class="p">(</span><span class="n">y_range</span> <span class="o">/</span> <span class="mi">10</span><span class="p">,</span> <span class="mi">1</span><span class="p">))</span>

    <span class="n">ax</span><span class="p">.</span><span class="n">xaxis</span><span class="p">.</span><span class="n">set_major_locator</span><span class="p">(</span><span class="n">MultipleLocator</span><span class="p">(</span><span class="n">x_step</span><span class="p">))</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">xaxis</span><span class="p">.</span><span class="n">set_minor_locator</span><span class="p">(</span><span class="n">AutoMinorLocator</span><span class="p">(</span><span class="mi">2</span><span class="p">))</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">yaxis</span><span class="p">.</span><span class="n">set_major_locator</span><span class="p">(</span><span class="n">MultipleLocator</span><span class="p">(</span><span class="n">y_step</span><span class="p">))</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">yaxis</span><span class="p">.</span><span class="n">set_minor_locator</span><span class="p">(</span><span class="n">AutoMinorLocator</span><span class="p">(</span><span class="mi">5</span><span class="p">))</span>

    <span class="n">ax</span><span class="p">.</span><span class="n">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="n">which</span><span class="o">=</span><span class="s">"major"</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="s">"-"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.8</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.35</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#4C4C4C"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="n">which</span><span class="o">=</span><span class="s">"minor"</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="s">"--"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.2</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#4C4C4C"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">set_title</span><span class="p">(</span><span class="n">title</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">14</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">set_xlabel</span><span class="p">(</span><span class="n">xlabel</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">12</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">set_ylabel</span><span class="p">(</span><span class="n">ylabel</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">12</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">tick_params</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="s">"both"</span><span class="p">,</span> <span class="n">which</span><span class="o">=</span><span class="s">"major"</span><span class="p">,</span> <span class="n">labelsize</span><span class="o">=</span><span class="mi">11</span><span class="p">,</span> <span class="n">length</span><span class="o">=</span><span class="mi">6</span><span class="p">,</span> <span class="n">width</span><span class="o">=</span><span class="mf">1.0</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">tick_params</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="s">"both"</span><span class="p">,</span> <span class="n">which</span><span class="o">=</span><span class="s">"minor"</span><span class="p">,</span> <span class="n">length</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">width</span><span class="o">=</span><span class="mf">0.8</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">plot_samples</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">x_values</span><span class="p">,</span> <span class="n">y_values</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"Samples"</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.9</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">sns</span><span class="p">.</span><span class="n">scatterplot</span><span class="p">(</span>
        <span class="n">x</span><span class="o">=</span><span class="n">x_values</span><span class="p">,</span> <span class="n">y</span><span class="o">=</span><span class="n">y_values</span><span class="p">,</span>
        <span class="n">s</span><span class="o">=</span><span class="mi">42</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#2E86AB"</span><span class="p">,</span>
        <span class="n">edgecolor</span><span class="o">=</span><span class="s">"white"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.6</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="n">alpha</span><span class="p">,</span>
        <span class="n">ax</span><span class="o">=</span><span class="n">ax</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">label</span>
    <span class="p">)</span>


<span class="n">configure_plot_style</span><span class="p">()</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">9</span><span class="p">,</span> <span class="mf">5.5</span><span class="p">))</span>
<span class="n">plot_samples</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">x_samples</span><span class="p">,</span> <span class="n">y_samples</span><span class="p">)</span>
<span class="n">apply_axis_style</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">x_samples</span><span class="p">,</span> <span class="n">y_samples</span><span class="p">,</span> <span class="s">"Log Relationship with Heteroscedastic Noise"</span><span class="p">)</span>
<span class="n">sns</span><span class="p">.</span><span class="n">despine</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="n">tight_layout</span><span class="p">()</span>
</code></pre></div></div>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-11-%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E7%AE%97%E4%BE%8B/%E5%9B%BE1_%E6%B5%8B%E8%AF%95%E6%95%B0%E6%8D%AE.png" width="700" />
</div>

<hr />
<h2 id="三同方差-vs-异方差gam建模"><strong>三、同方差 vs 异方差GAM建模</strong></h2>

<h3 id="31-同方差模型"><strong>3.1 同方差模型</strong></h3>

<p>接下来，采用GAM对数据进行拟合：</p>

<p>先给出同方差基线模型。这里的 <code class="language-plaintext highlighter-rouge">LinearGAM</code> 使用单一噪声尺度，因此适合作为对照，而不是最终的异方差解法。</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">gam_homo</span> <span class="o">=</span> <span class="n">LinearGAM</span><span class="p">(</span>
    <span class="n">n_splines</span><span class="o">=</span><span class="mi">10</span><span class="p">,</span>
    <span class="n">spline_order</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span>
    <span class="n">fit_intercept</span><span class="o">=</span><span class="bp">True</span>
<span class="p">).</span><span class="n">fit</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">y_samples</span><span class="p">)</span>
</code></pre></div></div>

<p>绘制同方差基线模型的均值曲线、95% 置信区间（CI）和 95% 预测区间（PI）。</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">y_pred_homo</span> <span class="o">=</span> <span class="n">gam_homo</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X</span><span class="p">)</span>
<span class="n">y_ci_homo</span> <span class="o">=</span> <span class="n">gam_homo</span><span class="p">.</span><span class="n">confidence_intervals</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">width</span><span class="o">=</span><span class="mf">0.95</span><span class="p">)</span>
<span class="n">y_pi_homo</span> <span class="o">=</span> <span class="n">gam_homo</span><span class="p">.</span><span class="n">prediction_intervals</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">width</span><span class="o">=</span><span class="mf">0.95</span><span class="p">)</span>

<span class="n">configure_plot_style</span><span class="p">()</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">9</span><span class="p">,</span> <span class="mf">5.5</span><span class="p">))</span>
<span class="n">plot_samples</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">x_samples</span><span class="p">,</span> <span class="n">y_samples</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">fill_between</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">y_pi_homo</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">y_pi_homo</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="s">"#8E9AAF"</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.22</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"95% PI (homoscedastic)"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">y_pred_homo</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#E76F51"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">2.2</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"LinearGAM mean"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">fill_between</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">y_ci_homo</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">y_ci_homo</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="s">"#E76F51"</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.25</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"95% CI (mean)"</span><span class="p">)</span>
<span class="n">apply_axis_style</span><span class="p">(</span>
    <span class="n">ax</span><span class="p">,</span>
    <span class="n">x_samples</span><span class="p">,</span>
    <span class="n">np</span><span class="p">.</span><span class="n">concatenate</span><span class="p">([</span><span class="n">y_samples</span><span class="p">,</span> <span class="n">y_pi_homo</span><span class="p">.</span><span class="n">ravel</span><span class="p">()]),</span>
    <span class="s">"Homoscedastic LinearGAM: 95% CI vs 95% PI"</span>
 <span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">sns</span><span class="p">.</span><span class="n">despine</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="n">tight_layout</span><span class="p">()</span>
</code></pre></div></div>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-11-%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E7%AE%97%E4%BE%8B/%E5%9B%BE2_%E5%90%8C%E6%96%B9%E5%B7%AEGAM%E6%95%88%E6%9E%9C.png" width="700" />
</div>

<p>可以看到，基线模型的均值拟合是合理的，但其预测区间宽度变化较弱。原因是默认 <code class="language-plaintext highlighter-rouge">LinearGAM</code> 把噪声方差看作常数，因此不能显式表达“噪声随 $x$ 增大”的结构。</p>

<h3 id="32-异方差模型"><strong>3.2 异方差模型</strong></h3>

<p>下面使用 LinearGAM + FGLS 做近似异方差建模。思路分三步：</p>
<ol>
  <li>先用基线模型得到残差；</li>
  <li>对 $\log(\hat\varepsilon^2)$ 再拟合一个 GAM，估计方差函数；</li>
  <li>用 $1/\hat\sigma^2(x)$ 作为权重重新拟合均值模型。</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">residuals_homo</span> <span class="o">=</span> <span class="n">y_samples</span> <span class="o">-</span> <span class="n">y_pred_homo</span>

<span class="n">eps</span> <span class="o">=</span> <span class="mf">1e-10</span>
<span class="n">log_res2</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="n">residuals_homo</span> <span class="o">**</span> <span class="mi">2</span> <span class="o">+</span> <span class="n">eps</span><span class="p">)</span>
<span class="n">var_gam</span> <span class="o">=</span> <span class="n">LinearGAM</span><span class="p">(</span>
    <span class="n">n_splines</span><span class="o">=</span><span class="mi">10</span><span class="p">,</span>
    <span class="n">spline_order</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span>
    <span class="n">fit_intercept</span><span class="o">=</span><span class="bp">True</span>
<span class="p">).</span><span class="n">fit</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">log_res2</span><span class="p">)</span>

<span class="n">sigma_sq_fgls</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="n">var_gam</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X</span><span class="p">))</span>
<span class="n">weights_fgls</span> <span class="o">=</span> <span class="mf">1.0</span> <span class="o">/</span> <span class="n">np</span><span class="p">.</span><span class="n">clip</span><span class="p">(</span><span class="n">sigma_sq_fgls</span><span class="p">,</span> <span class="mf">1e-6</span><span class="p">,</span> <span class="bp">None</span><span class="p">)</span>

<span class="n">gam_fgls</span> <span class="o">=</span> <span class="n">LinearGAM</span><span class="p">(</span>
    <span class="n">n_splines</span><span class="o">=</span><span class="mi">10</span><span class="p">,</span>
    <span class="n">spline_order</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span>
    <span class="n">fit_intercept</span><span class="o">=</span><span class="bp">True</span>
<span class="p">).</span><span class="n">fit</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">y_samples</span><span class="p">,</span> <span class="n">weights</span><span class="o">=</span><span class="n">weights_fgls</span><span class="p">)</span>

<span class="n">y_pred_fgls</span> <span class="o">=</span> <span class="n">gam_fgls</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X</span><span class="p">)</span>
<span class="n">y_ci_fgls</span> <span class="o">=</span> <span class="n">gam_fgls</span><span class="p">.</span><span class="n">confidence_intervals</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">width</span><span class="o">=</span><span class="mf">0.95</span><span class="p">)</span>
<span class="n">sigma_fgls</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">sqrt</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="n">var_gam</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X</span><span class="p">)))</span>
<span class="n">z_score</span> <span class="o">=</span> <span class="mf">1.96</span>
<span class="n">y_pi_fgls</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">column_stack</span><span class="p">([</span>
    <span class="n">y_pred_fgls</span> <span class="o">-</span> <span class="n">z_score</span> <span class="o">*</span> <span class="n">sigma_fgls</span><span class="p">,</span>
    <span class="n">y_pred_fgls</span> <span class="o">+</span> <span class="n">z_score</span> <span class="o">*</span> <span class="n">sigma_fgls</span><span class="p">,</span>
<span class="p">])</span>

<span class="k">print</span><span class="p">(</span><span class="s">"FGLS 拟合完成：已同时得到均值模型和随 x 变化的噪声标准差估计。"</span><span class="p">)</span>
</code></pre></div></div>

<p>FGLS 拟合完成：已同时得到均值模型和随 x 变化的噪声标准差估计。</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">configure_plot_style</span><span class="p">()</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">14</span><span class="p">,</span> <span class="mf">5.5</span><span class="p">))</span>

<span class="n">ax</span> <span class="o">=</span> <span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
<span class="n">plot_samples</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">x_samples</span><span class="p">,</span> <span class="n">y_samples</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">fill_between</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">y_pi_homo</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">y_pi_homo</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="s">"#A0A0A0"</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.2</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"95% PI (homoscedastic)"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">fill_between</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">y_pi_fgls</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">y_pi_fgls</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="s">"#4E5A6E"</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.4</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"95% PI (heteroscedastic)"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">y_pred_fgls</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#E76F51"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">2.3</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"FGLS mean"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">y_true</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#1D3557"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">1.8</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="s">"--"</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.75</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"True mean"</span><span class="p">)</span>
<span class="n">apply_axis_style</span><span class="p">(</span>
    <span class="n">ax</span><span class="p">,</span>
    <span class="n">x_samples</span><span class="p">,</span>
    <span class="n">np</span><span class="p">.</span><span class="n">concatenate</span><span class="p">([</span><span class="n">y_samples</span><span class="p">,</span> <span class="n">y_pi_homo</span><span class="p">.</span><span class="n">ravel</span><span class="p">(),</span> <span class="n">y_pi_fgls</span><span class="p">.</span><span class="n">ravel</span><span class="p">()]),</span>
    <span class="s">"Prediction Interval: Homoscedastic vs Heteroscedastic"</span>
 <span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

<span class="n">ax</span> <span class="o">=</span> <span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
<span class="n">ax</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">noise_scale</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#1D3557"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">2.2</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="s">"--"</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"True noise std"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="n">sigma_fgls</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#E76F51"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">2.2</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">"Estimated noise std"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">fill_between</span><span class="p">(</span><span class="n">x_samples</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">sigma_fgls</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">"#E76F51"</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.12</span><span class="p">)</span>
<span class="n">apply_axis_style</span><span class="p">(</span>
    <span class="n">ax</span><span class="p">,</span>
    <span class="n">x_samples</span><span class="p">,</span>
    <span class="n">np</span><span class="p">.</span><span class="n">concatenate</span><span class="p">([</span><span class="n">noise_scale</span><span class="p">,</span> <span class="n">sigma_fgls</span><span class="p">]),</span>
    <span class="s">"Noise Std: Truth vs FGLS Estimate"</span><span class="p">,</span>
    <span class="n">ylabel</span><span class="o">=</span><span class="s">"Standard deviation"</span>
 <span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

<span class="n">sns</span><span class="p">.</span><span class="n">despine</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="n">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<div style="text-align: center;">
    <img src="/academicpages/images/posts/2026-05-11-%E5%B9%BF%E4%B9%89%E5%8A%A0%E6%80%A7%E6%A8%A1%E5%9E%8B%E7%AE%97%E4%BE%8B/%E5%9B%BE3_%E5%90%8C%E5%BC%82%E6%96%B9%E5%B7%AEGAM%E6%95%88%E6%9E%9C%E5%AF%B9%E6%AF%94.png" width="1000" />
</div>

<hr />
<h2 id="四结论"><strong>四、结论</strong></h2>

<ol>
  <li>默认 <code class="language-plaintext highlighter-rouge">LinearGAM</code> 更适合作为同方差基线，它的 PI 宽度主要由单一噪声尺度决定；</li>
  <li><code class="language-plaintext highlighter-rouge">LinearGAM + FGLS</code> 通过“残差建模 + 加权重拟合”可以近似刻画异方差；</li>
  <li>在这个合成示例里，FGLS 给出的预测区间会随 $x$ 增大而变宽，同时估计出的噪声标准差也能较好追踪真实趋势。</li>
</ol>]]></content><author><name>罗磊</name><email>dreisteine262@163.com</email></author><summary type="html"><![CDATA[本算例展示三项内容： 先用默认的 LinearGAM 作为同方差基线； 再用 LinearGAM + FGLS 近似处理异方差； 对比两种预测区间在噪声随 $x$ 增大时的差异。]]></summary></entry></feed>